Izradio sam hrvatski LLM za RAG od nule s 300 milijuna parametara. Radi na CPU-u
Nakon prošlog GPT-2, ovaj put sam izradio hrvatski LLM od nule na jednoj RTX 4090. Cilj je bio RAG: model koji među zadanim tekstom pronađe odgovor i pritom citira jednu rečenicu kao dokaz. I u produkciji treba raditi na CPU-u.
Prvo zaključak.
- Od nule do završetka trebalo je oko 68 sati na GPU-u (uključujući pokušaje i pogreške). Od toga je predtrening trajao 51 sat
- 320 milijuna parametara. Točno odgovara na 71 % pitanja o odlomcima i na 44 % pitanja o dugim tekstovima od oko 3.000 tokena
- Samo na CPU-u odgovara na jedno pitanje za 3 do 16 sekundi. Tekst se ispisuje dovoljno brzo da ga možete pratiti pogledom
Vrijeme potrebno za treniranje
| Faza | Vrijeme | Sadržaj |
|---|---|---|
| Generiranje podataka za treniranje | oko 4,5 sata | Uz EuroLLM-9B (vLLM), 45.000 Wikipedia QA primjera i 50.000 prijevoda razgovora |
| Tokenizator i tokenizacija | oko 2,5 sata (CPU) | Vlastiti rječnik od 32.000 riječi za hrvatski |
| Predtrening | 50 sati i 46 minuta | 7 milijardi tokena. U zadnjih 10 % kontekst je produljen na 4.096 |
| SFT | oko 35 minuta | Učenje odgovaranja s citatima i odbijanja odgovora kada ga nema |
| Učenje potkrepljivanjem (GRPO) | oko 11 sati | 400 koraka, zatim prilagodba i još 300 koraka |
Vlastiti tokenizator može hrvatski prikazati s otprilike upola manje tokena nego GPT-2 tokenizator. To znači da s 4.096 tokena može pročitati oko 17.000 znakova.
Dobiveni model
| Stavka | Sadržaj |
|---|---|
| Parametri | 320 milijuna (24 sloja, 1024 dimenzije) |
| Arhitektura | Llama / Qwen3 sustav (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| Duljina konteksta | 4.096 tokena |
| Format izlaza | Odgovor + Izvor: „jedna rečenica preuzeta izravno iz konteksta“. Ako nema odgovora: „U tekstu nema odgovora na ovo pitanje.“ |
| Izvršavanje | Namijenjeno CPU-u (oko 1,3 GB u fp32) |
Uz to sam izvana dodao mehanizam koji programatski provjerava nalazi li se generirani citat doista u kontekstu te ga, ako ne nalazi, zamjenjuje porukom „nema odgovora”. Bit je ne vjerovati modelu bez rezerve, nego omogućiti provjeru izvora.
Problemi koje sam otkrio izradom
1. Izmišlja odgovor svaki put, čak i kada odgovora nema. U početku sam ga učio samo običnom odgovaranju na pitanja. Točnost je porasla, ali kad bih mu dao tekst bez odgovora, u 100 % slučajeva smislio bi uvjerljiv odgovor. Upravo ono što je najgore kod RAG-a. Kad sam ga naučio citiranju i „odbijanju”, izmišljanje se smanjilo na nekoliko posto.
2. Prečesto odbija odgovoriti. Kada sam kod učenja potkrepljivanjem bodovanje postavio na „−0,5 za pogrešku, 0 za odbijanje”, na teškim dugim tekstovima naučio je da mu se isplati pobjeći odbijanjem, pa je odbijao čak 70 % pitanja. Savršeno je pronašao rupu u pravilima ocjenjivanja. Kad sam odbijanje postavio na −0,3, otišao je u drugu krajnost: gotovo više nije odbijao, a izmišljanja su dosegla 40 %. Njihao se poput klackalice.
3. Pogreške pri prepisivanju citata. Kod dugih tekstova odgovor je točan, ali model promijeni redoslijed riječi u citatu ili citira prvu rečenicu članka. Kod dugog konteksta i citat je bio točan tek u otprilike polovici slučajeva.
4. Pogreške koje prolaze provjeru. Točno je citirao rečenicu „rođen je u ○○” iz drugog članka koji je bio umetnut u kontekst te naveo rodno mjesto druge osobe. Citat je stvaran, pa ga provjera ne može zaustaviti.
5. Rupe u evaluacijskim podacima. Bilo je primjera gdje je u kontekstu koji je trebao biti „bez odgovora” ostao dio odgovora; model je bio u pravu, ali je procijenjen kao da je „izmislio” odgovor.
Konačne performanse
Po 300 pitanja za svaku procjenu. Korišten je model nakon 100 koraka prilagođenog učenja potkrepljivanjem, jer je imao najbolju ravnotežu između odbijanja i odgovaranja.
| Kontekst | Točno | Pogrešno | Odbio odgovoriti |
|---|---|---|---|
| Odlomak (oko 100–400 tokena) | 71,3 % | 16,7 % | 12,0 % |
| Dugi kontekst (1.500–3.500 tokena) | 44,0 % | 20,3 % | 35,7 % |
| Kontekst bez odgovora | Ispravno odbio | Izmislio odgovor |
|---|---|---|
| Odlomak | 97,7 % | 2,3 % |
| Dugi kontekst | 92,3 % | 7,7 % |
Nakon provjere, udio točnih među odgovorima koje je model dao iznosio je 73,8 %. Ciljanih 90 % još je daleko.
Usput, kada sam ga pustio da riješi jedno pitanje osam puta i računao uspjeh ako je barem jednom pogodio, dosezao je 91 % na odlomcima i 74 % na dugim tekstovima (mjereno na posljednjem checkpointu). Taj se broj gotovo nije promijenio prije i poslije učenja potkrepljivanjem; promijenilo se to može li riješiti problem svaki put. Brojke su jasno pokazale da učenje potkrepljivanjem nije toliko dodavanje novih sposobnosti, koliko pretvaranje problema koje povremeno može riješiti u probleme koje može riješiti svaki put.
Pokretanje na CPU-u
Izradio sam testni web UI i pokrenuo ga samo na CPU-u (i7-13700K). Brzina pojavljivanja teksta izravno odgovara brzini generiranja.
Odlomak (263 tokena): 0,3 sekunde do prvog znaka, oko 11 tokena/s, ukupno 7 sekundi
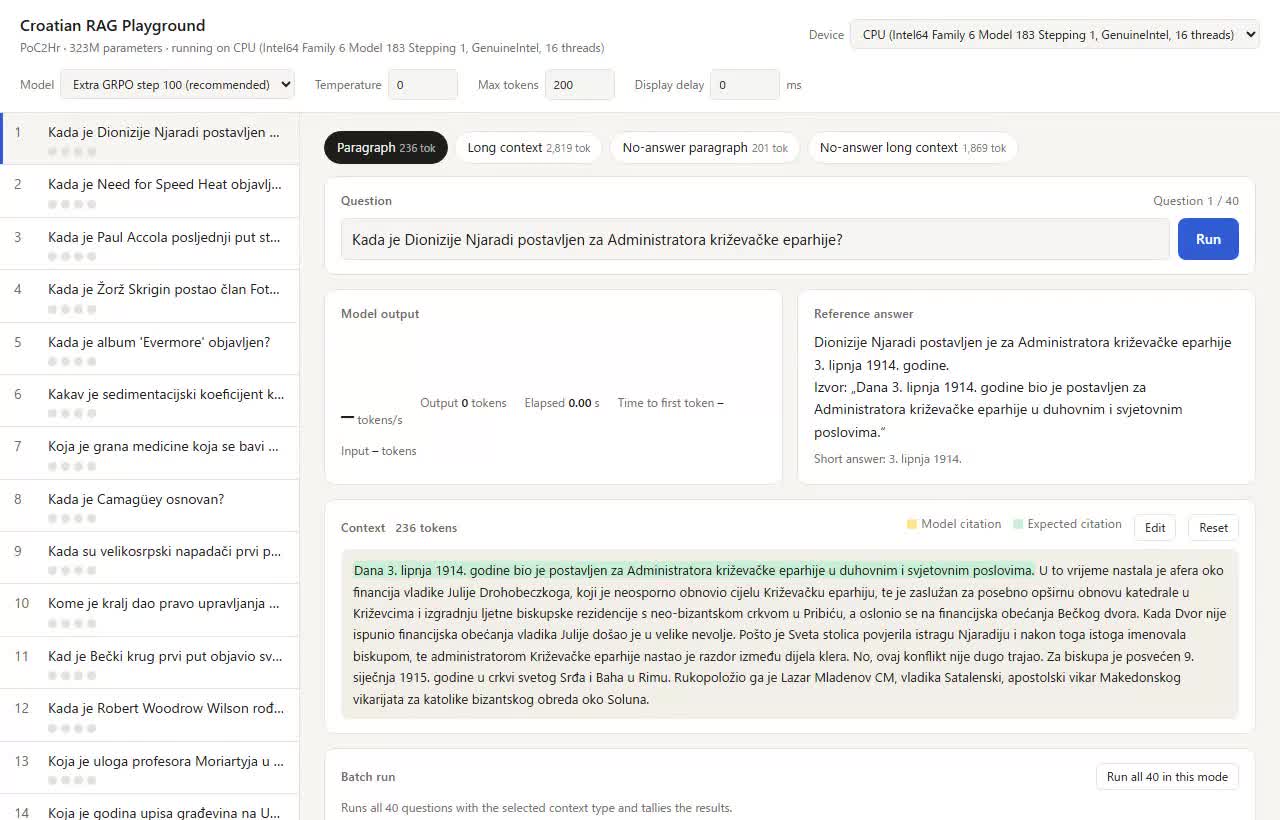
Dugi kontekst (3.215 tokena): za učitavanje teksta treba oko 5 sekundi, oko 5 tokena/s, ukupno 19 sekundi. Žuto je citirana rečenica i model je doista pronašao ispravnu rečenicu među 3.000 tokena
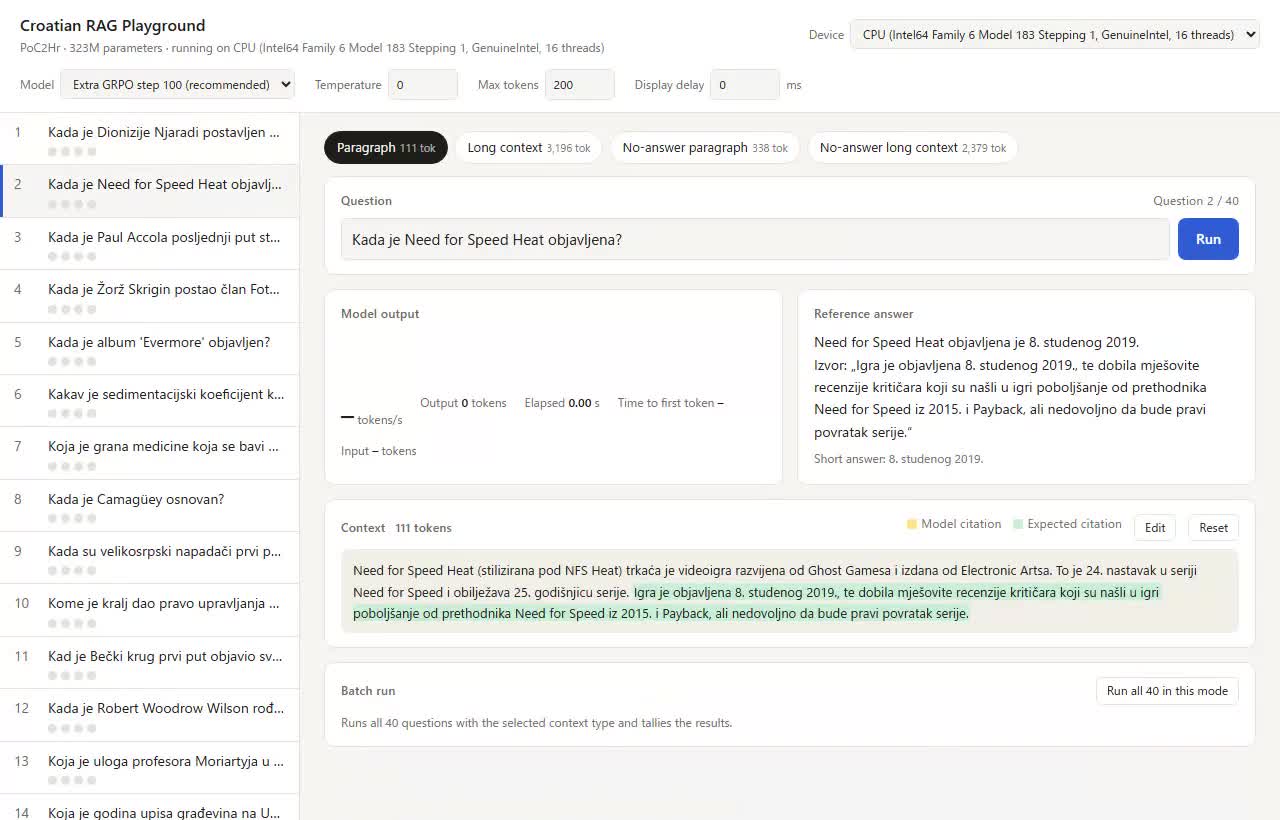
Video je malo sporiji jer je sniman tijekom rada. Pri mjerenju 20 pitanja bez snimanja, odlomci su radili 15 tokena/s i 3,4 sekunde po pitanju, a dugi kontekst 7 tokena/s i 16 sekundi po pitanju. Budući da su odgovori kratki, oko 50 tokena, čini se da je brzina praktično upotrebljiva čak i na CPU-u.
Razmatranja
- Kod malih modela najvažnije je naučiti ih reći „ne znam ono što ne znam”. Za RAG je važnije smanjiti izmišljanja nego povećati točnost. Kombinacija citiranja, odbijanja i vanjske provjere pokazala se vrlo učinkovitom
- 300 milijuna parametara granica je za duge tekstove. Čak i uz osam pokušaja dugi tekstovi dosežu samo 74 %. Za cilj od 90 % na dugim tekstovima trebalo bi oko milijardu parametara
- Provjera ne smije stati na tome postoji li citat doista. Treba provjeriti sadrži li citat broj ili ime iz odgovora te je li subjekt isti kao osoba iz pitanja
- Model od 300 milijuna parametara koji radi na CPU-u taman je za Q&A nad dokumentima koji se ne smiju slati na internet. Na prijenosnom računalu ili poslužitelju bez GPU-a može odgovarati samo na temelju lokalnih dokumenata. Brzina je nekoliko do desetak sekundi po pitanju, a kvantizacija bi ga vjerojatno mogla dodatno ubrzati (nije provjereno)
Sljedeće želim pokušati s verzijom od milijardu parametara i ciljati 90 % na dugom kontekstu.