Napravio sam GPT-2 od nule s jednom RTX 4090. Za jedan dan nadmašio sam original i omogućio mu chat
Pokušao sam od nule istrenirati GPT-2 (124M) na jednoj RTX 4090 kod kuće. Sve sam radio na vlastitom računalu: od pripreme podataka i predtreniranja do ugađanja instrukcijama (SFT) kako bi mogao razgovarati.
Evo zaključka unaprijed:
- Predtreniranje je završeno za oko 21 sat. Na testu rezoniranja općeg znanja HellaSwag postigao je 30,5 %. To je više od 29,4 % koliko ima originalni GPT-2 124M
- SFT je trajao nešto manje od 2 sata. Već nakon samo 5 minuta od početka učenja počeo je davati odgovore nalik razgovoru
- No sadržaj je prepun halucinacija. Bez problema kaže stvari poput „Pariz ima 2,4 milijarde stanovnika” ili „12+7=30”
Bilo mi je zanimljivo pratiti kako GPT-2 postupno postaje pametniji, pa sam sažeo taj proces.
Okruženje
- GPU: RTX 4090 (24 GB)
- CPU: i7-13700K / 64 GB memorije
- OS: Windows 11 (bez WSL-a, izravno na Windowsu)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
Kod je napravljen po istom pristupu kao Karpathyjev nanoGPT/build-nanogpt. Zamolio sam Claude Code da „napravi GPT-2 koji se može istrenirati za jedan dan na GPU-u ovog računala” te mi je pomogao sa svime, od prijedloga strukture i izrade skripti do praćenja učenja.
Priprema podataka: 10B tokena spremno za 12 minuta
Podaci za učenje bili su verzija od 10B tokena skupa FineWeb-Edu (visokokvalitetni obrazovni engleski tekstovi s weba). U parquet formatu zauzimaju oko 27 GB.
Isprva je preuzimanje putem običnog Hugging Facea išlo samo 1,7 MB/s, pa bi za cijeli skup trebalo više od četiri sata. Nakon što sam instalirao hf_transfer, brzina je porasla na 60–70 MB/s, a datoteka od 2 GB preuzima se za 30 sekundi. Usko grlo prebacilo se na tokenizaciju te je preuzimanje i tokenizacija zajedno trajala oko 12 minuta.
Usput, isprva sam HF_HOME, kojim se mijenja mjesto spremanja predmemorije, postavio nakon importa huggingface_hub. Zato postavka nije djelovala i podaci su se preuzimali na drugi disk. Ta se varijabla okruženja čita pri importu, zato ju je potrebno postaviti prije importa. Lako se na tome zapeti.
Postavke učenja
| Stavka | Sadržaj |
|---|---|
| Model | GPT-2 small (12 slojeva, 768 dimenzija, 124 milijuna parametara) |
| 1 korak | Oko 520 tisuća tokena (16×1024 uz 32 akumulacije gradijenta) |
| Broj koraka | 16.000 (oko 8,4B tokena) |
| Brzina | Oko 120 tisuća tokena/s |
| VRAM | Oko 12 GB |
Često se može čuti da na Windowsu torch.compile ne radi pa treba koristiti WSL, ali u okruženju s triton-windowsom radio je izravno.
Sa svih 10B tokena učenje bi trajalo više od 24 sata, pa sam ga smanjio na 8,4B tokena kako bi stalo u jedan dan.
Kao mali trik, broj tokena u rječniku zaokružen je s 50257 na 50304 (višekratnik od 128). To je poznata Karpathyjeva tehnika koja ubrzava GPU matrične izračune, a kasnije se neočekivano pokazala korisnom pri pretvaranju modela u chat.
Incident: učenje je stalo nakon 2,5 sata
Kad sam provjerio napredak, učenje je bilo stalo. Uzrok su bili evaluacijski podaci za HellaSwag. Kod iz obitelji nanoGPT preuzima podatke s GitHuba, iz rowanz/hellaswag, ali tamo je stajala poruka „451 Unavailable For Legal Reasons” (nedostupno iz pravnih razloga). Zbog pogreške 404 cijelo je učenje palo zajedno s evaluacijom.
Prebacio sam čitanje na Rowan/hellaswag na Hugging Faceu (isti sadržaj, 10.042 pitanja) i nastavio s kontrolne točke koja se spremala svakih 500 koraka. Također sam evaluaciju omotao u try/except kako neuspjeh evaluacije ne bi zaustavio učenje.
Pri dugotrajnom učenju ne smije se dopustiti da učenje padne zbog kvara „sporednih” dijelova, poput evaluacije ili zapisivanja logova. To je važno.
Rezultat: nadmašio je originalni GPT-2
Loss na validacijskim podacima izgledao je ovako. U prvom satu naglo je pao, a zatim se postupno smanjivao.
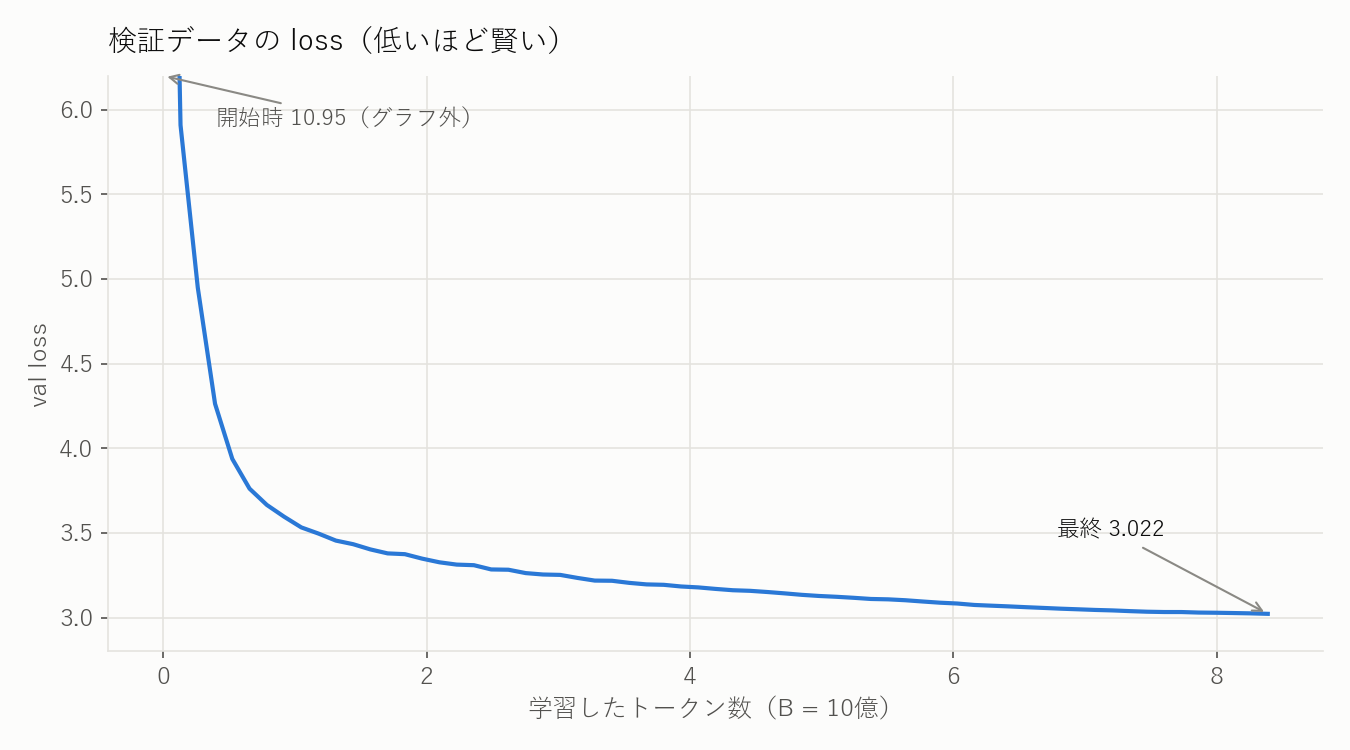
Početni loss od 10,95 gotovo je jednak vrijednosti ln(50304)≒10,83. Drugim riječima, model je krenuo iz stanja u kojem potpuno nasumično bira među 50 tisuća riječi.
Točnost na HellaSwagu bila je sljedeća.
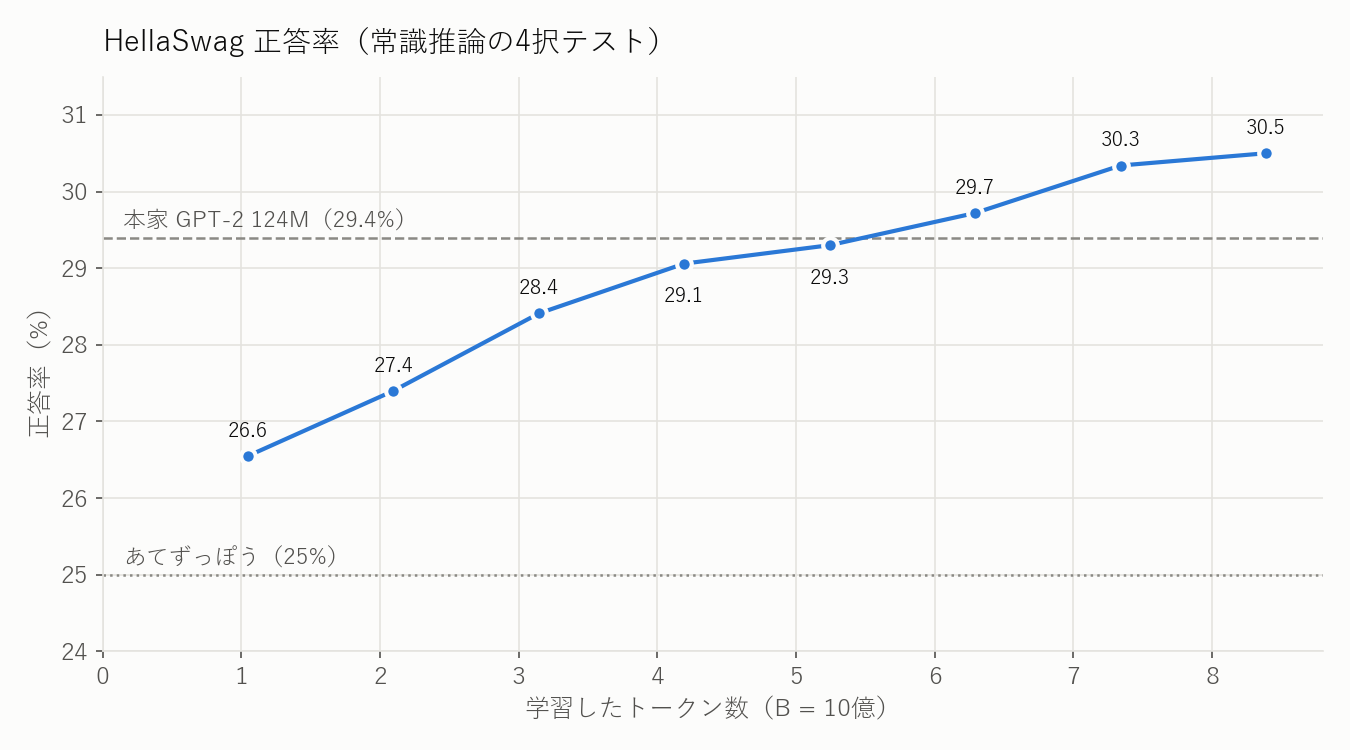
Nakon otprilike 6,3B tokena (korak 12.000) nadmašio je 29,4 % originalnog GPT-2 124M-a, a na kraju je dosegnuo 30,5 %. Originalni GPT-2 učio je na WebTextu. Ovdje je korišten FineWeb-Edu, a vjerujem da je razliku donijela kvaliteta obrazovnih podataka.
Kako je postupno postajao pametniji
Tijekom učenja svakog sam sata generirao tekst iz istog prompta i bilježio ga. To je bio najzanimljiviji dio.
Prije učenja (nasumično stanje)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
Riječi su samo potpuno nasumično poslagane.
Nakon 37 minuta (0,26B tokena)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
Već ima oblik rečenice. Razumije da se radi o „priči o glavnom gradu”, ali glavni grad Francuske naziva glavnim gradom Škotske.
Nakon otprilike 2 sata (0,79B tokena)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
Gramatika je već prilično prirodna. S druge strane, počeo je nizati stručne pojmove i iznositi uvjerljive laži. Djeluje kao začetak halucinacija.
Oko 2,1B tokena
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
Napokon je rekao Paris! …A onda je odmah dodao lažnu statistiku da „Francuska proizvodi 50 % svjetskog čelika”.
Pitao sam dovršeni osnovni model nekoliko pitanja
Postavio sam mu deset pitanja u obliku Question: ... Answer:.
- What is the capital of France? → izlista opcije od (a) do (i) i počne sastavljati zbirku zadataka
- Who was Albert Einstein? → „Rođen je 16. studenog 1918. u St. Louisu, Missouri. Otac mu je bio rudar, a on učitelj.” Sve je laž, ali zna pisati u obliku biografije
- What is 12 plus 7? → „12 plus 7 is an arithmetic expression.” Umjesto računanja, počne objašnjavati definiciju
Ima nešto znanja, ali ne zna ponašanje „odgovaranja na pitanje”. Osnovni model je ipak samo stroj za „pisanje nastavka teksta”, stoga je to očekivano.
Omogućio sam mu chat uz SFT
Zatim sam odradio ugađanje instrukcijama (SFT) kako bi mogao odgovarati na pitanja poput ChatGPT-a.
- Podaci:
smol-smoltalks Hugging Facea (oko 460 tisuća razgovora, 270 milijuna tokena) - Format chata: dodani su razdjelnici poput
<|user|><|assistant|><|end|>. Ovdje sam ponovno iskoristio slobodne brojeve nastale ranijim zaokruživanjem rječnika na 50304. Tako je bilo moguće dodati posebne tokene bez promjene strukture modela, pa je trik za brzinu ovdje dobro došao - Uči se samo dio s odgovorom: pitanje se samo čita, dok model oponaša samo odgovor asistenta i završni
<|end|> - 2 epohe, oko 1 sat i 50 minuta
Ključno je učiti model sve do <|end|>. Tako model sam stane kada završi govoriti. ChatGPT i slični modeli rade po istom principu: generiranje se zaustavlja kada ispuste završni token.
Nakon samo 5 minuta počeo je nalikovati razgovoru
Prije početka SFT-a (korak 0) nepoznati razdjelnici zbunjivali su model i on je upadao u beskonačnu petlju „jakjakjakjak…”. Već nakon 500 koraka (oko 5 minuta) postao je nalik razgovoru.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
Štoviše, uredno završi i stane. Način govora naučio je u trenu.
No znanje je ostalo isto. Model je usred učenja znao reći da je „Pariz najveći grad na svijetu, s oko 2,4 milijarde stanovnika”.
Usporedba prije i nakon SFT-a
Usporedio sam osnovni model prije SFT-a i model nakon njega na istim pitanjima.
| Pitanje | Prije SFT-a | Nakon SFT-a |
|---|---|---|
| What is the capital of France? | Počne nizati opcije od (a) do (i) | „The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.” |
| Who are you? | „I am the person who has the gift for all that I do.” | „I'm a language learning AI assistant with over 10 years of experience” (AI s 10 godina iskustva) |
| Translate "Good morning" into French. | Počne govoriti o nečemu nepovezanom s pitanjem | „Bonjour!” (točno, ali nakon toga beskonačno ponavlja „Good morning (modifier)”) |
| What is 12 plus 7? | „arithmetic expressionです” | „12 + 7 = 21” → „12 + 7 = 30” → „35 + 7 = 34”; uz naizgled uvjerljiv postupak sve više griješi |
| Who was Albert Einstein? | Učitelj čiji je otac bio rudar | Široko gledano odgovara „prominent physicist”. No „rođen je 24. veljače 1905. u Beču” je laž |
Ton i format potpuno su asistentski. Sadržaj je često lažan. Računanje je bilo katastrofalno.
Isprobao sam stvarni chat
Napravio sam chat.py za razgovor u terminalu i isprobao ga.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
Uspijeva slijediti uputu „u jednoj rečenici”. To osnovni model nije mogao.
U drugom razgovoru, nakon pitanja o glavnom gradu, nastavio sam pitanjem o stanovništvu.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
Iz prethodnog razgovora razumije da „there = Japan”. Ali odmah nakon tvrdnje da Japan ima 50 tisuća stanovnika kaže da na njegovu sjeveru živi 1,5 milijardi ljudi — potpuni kaos.
Kad sam na japanskom pitao „Koji je glavni grad Japana?”, odgovorio je ovako:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
Budući da je učio samo na engleskim podacima, japanski mu je očito izgledao kao neobičan tekst koji treba lektorirati.
Na kraju sam ga zamolio da „napiše haiku o GPU-u”, a on je stvorio pjesmu koja je beskrajno ponavljala „I see the world, the thoughts, the emotions”. Haiku, dakle.
Što sam naučio
- S jednom 4090 moguće je u jednom danu napraviti model koji nadmašuje originalni GPT-2. GPU je trošio oko 430 W. Samo za GPU struja je stajala okvirno 300 jena (procjena)
- Način govora nauči se trenutačno, ali znanje određuje predtreniranje. SFT je za pet minuta usvojio razgovorni format, ali se činjenična točnost gotovo nije promijenila
- Model od 124M ima gotovo savršenu gramatiku, ali je sadržaj prepun laži. Jasno se vidi da tečnost i točnost nisu ista stvar
- Dugotrajno učenje padne zbog infrastrukture. Ovaj put učenje nije stalo zbog modela, nego zato što je nestala lokacija evaluacijskih podataka
Kada ga sam napraviš od nule, intuitivno shvatiš da je AI poput ChatGPT-a stroj za „predviđanje nastavka teksta” kojem je podučena „kultura razgovora”. Sljedeći put želim pokušati izraditi model koji je malo praktičniji.