Testirao sam RAG performanse SLM-ova: usporedba 25 modela od 1B do 9B na hrvatskom i engleskom
Budući da sam napravio vlastiti hrvatski RAG model i čak ga kvantizirao, ovaj put sam provjerio koliko su mali modeli (SLM) koji postoje na tržištu upotrebljivi za RAG. Uz svoj model od 320 milijuna parametara, testirao sam ukupno 25 modela: 10 iz klase 1B, 8 iz klase 3B i 7 iz klase 7B, na istim pitanjima na hrvatskom i engleskom.
Naknadno (istog dana): Isprobao sam i tri mala modela napravljena posebno za RAG (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M). Rezultati su u drugom dijelu članka, pod naslovom „Naknadno: isprobao sam i modele posebno za RAG”.
Najprije zaključak.
- Klasa 3–4B već je gotovo izjednačena s klasom 8–9B. Ukupna točnost na hrvatskom iznosi 90% za Qwen3.5 4B i Gemma 4 E4B, dok prvoplasirani Qwen3.5 9B ima 91%
- Ključna je razlika može li model odbiti odgovor kada ga nema. Phi-4-mini, koji je pri vrhu po točnosti, izmislio je odgovor u 64% dugih tekstova bez odgovora
- Na engleskom više modela odbija odgovor iako on postoji. OLMo 3 7B odbio je 47% engleskih odlomaka, a MiniCPM5 2B njih 70%
- Na CPU-u modeli klase 7B za jedno pitanje s dugim tekstom trebaju više od 30 sekundi. Modeli klase 1B trebaju 4–13 sekundi. Moj model od 320 milijuna treba 2,1 sekundu, a točnošću je otprilike jednak Qwen3.5 0.8B
Što sam napravio
Pitanja: ista kao u prethodnom članku, izrađena iz hrvatske Wikipedije. Za svako pitanje dao sam četiri vrste teksta.
- Odlomak: odlomak od oko 100 tokena koji sadrži odgovor
- Dugi tekst: tekst od oko 3.000 tokena koji sadrži odgovor (pomiješani su i nepovezani članci)
- Bez odgovora (odlomak / dugi tekst): tekst koji ne sadrži odgovor. Točno je ako model odbije odgovor riječima „U tekstu nema odgovora”
Engleska verzija: ista pitanja preveo sam na engleski s pomoću EuroLLM-9B. Pitanja kod kojih je odgovor nestao u prijevodu ili je ostao na hrvatskom bez prijevoda uklonio sam iz oba jezika pa sam usporedio istih 260 pitanja.
Uputa: na svakom jeziku zadao sam: „Koristi samo tekst u nastavku i odgovori kratko, u jednoj rečenici. Ako nema odgovora, odgovori samo: ‘U tekstu nema odgovora’.”
Ocjenjivanje: Qwen3.5 9B je, uspoređujući odgovor s referentnim odgovorom, određivao „točno, netočno ili odbijeno”. Ručno sam provjerio 65 slučajeva i vidio da je ocjenjivanje bilo pomalo blago jer je i djelomične odgovore, primjerice samo godinu, priznavalo kao točne, ali procjena je li model odbio odgovor bila je točna u svim slučajevima.
Ukupna točnost: broj pitanja na koja je model točno odgovorio u odlomcima i dugim tekstovima, plus broj pitanja bez odgovora koja je odbio, podijeljen ukupnim brojem pitanja. To je brojka koja obuhvaća i točno odgovaranje i šutnju kada model ne zna.
Način pokretanja: točnost sam mjerio u vLLM-u na RTX-u 4090, uz generiranje koje svaki put bira riječ s najvećom vjerojatnošću. Isključio sam „način razmišljanja” kod modela koji najprije razmišljaju, a zatim odgovaraju. Modele klase 7B prebacio sam u FP8 kako bi stali u memoriju GPU-a.
Rezultati: točnost (hrvatski)
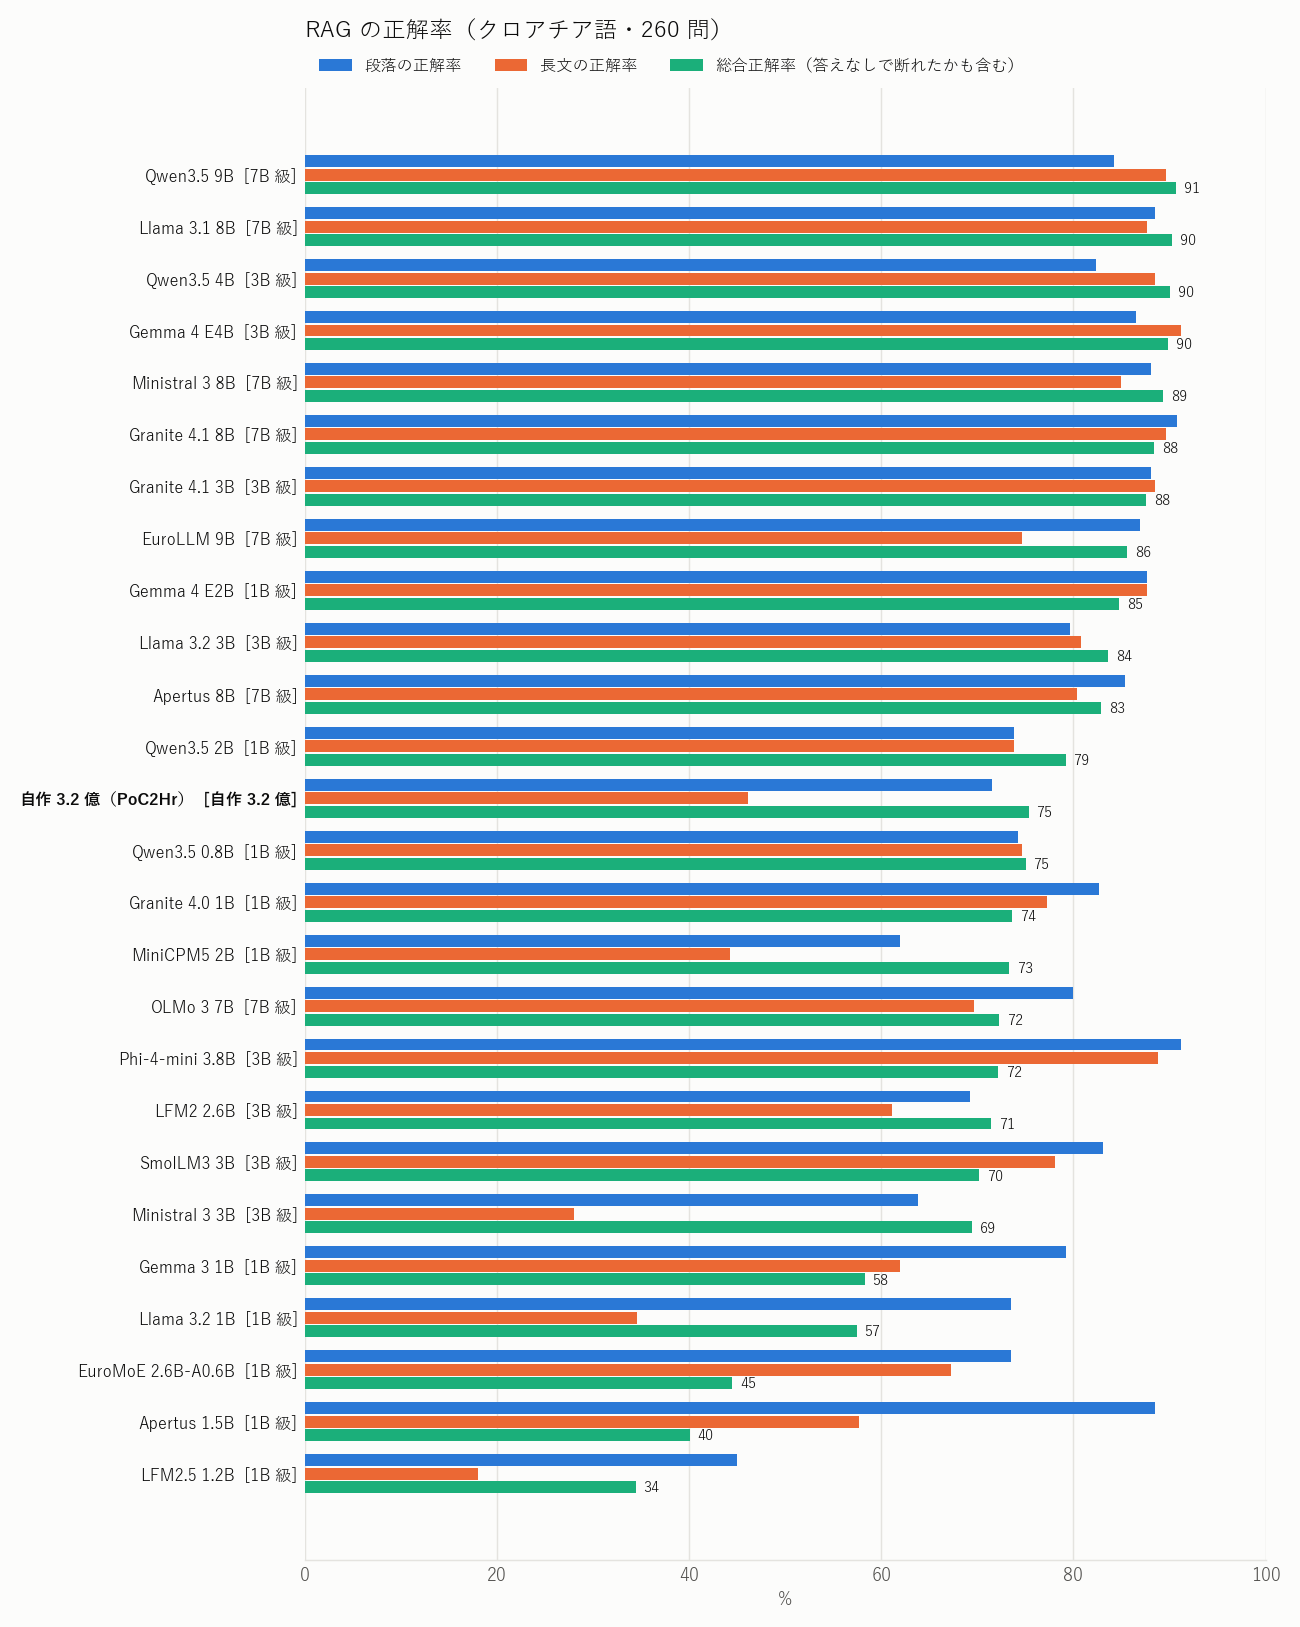
- Vrh je gotovo izjednačen na oko 90%. Qwen3.5 9B (91%), Llama 3.1 8B, Qwen3.5 4B i Gemma 4 E4B (90%)
- U klasi 1B izdvaja se Gemma 4 E2B (85%). Iako joj naziv kaže 2B, datoteka je veća, 3,2 GB
- Neki modeli imaju visoku točnost za odlomke i duge tekstove, ali padnu u ukupnom rezultatu. Phi-4-mini je s 91% za odlomke i 89% za duge tekstove u najvišoj skupini, ali ukupno ima 72%. Razlog je sljedeće „izmišljanje”
- Najgori je bio LFM2.5 1.2B (34%). Nije uspijevao točno odgovoriti na pitanja s odgovorom, a na pitanja bez odgovora izmišljao je odgovore
Rezultati: točnost (engleski)
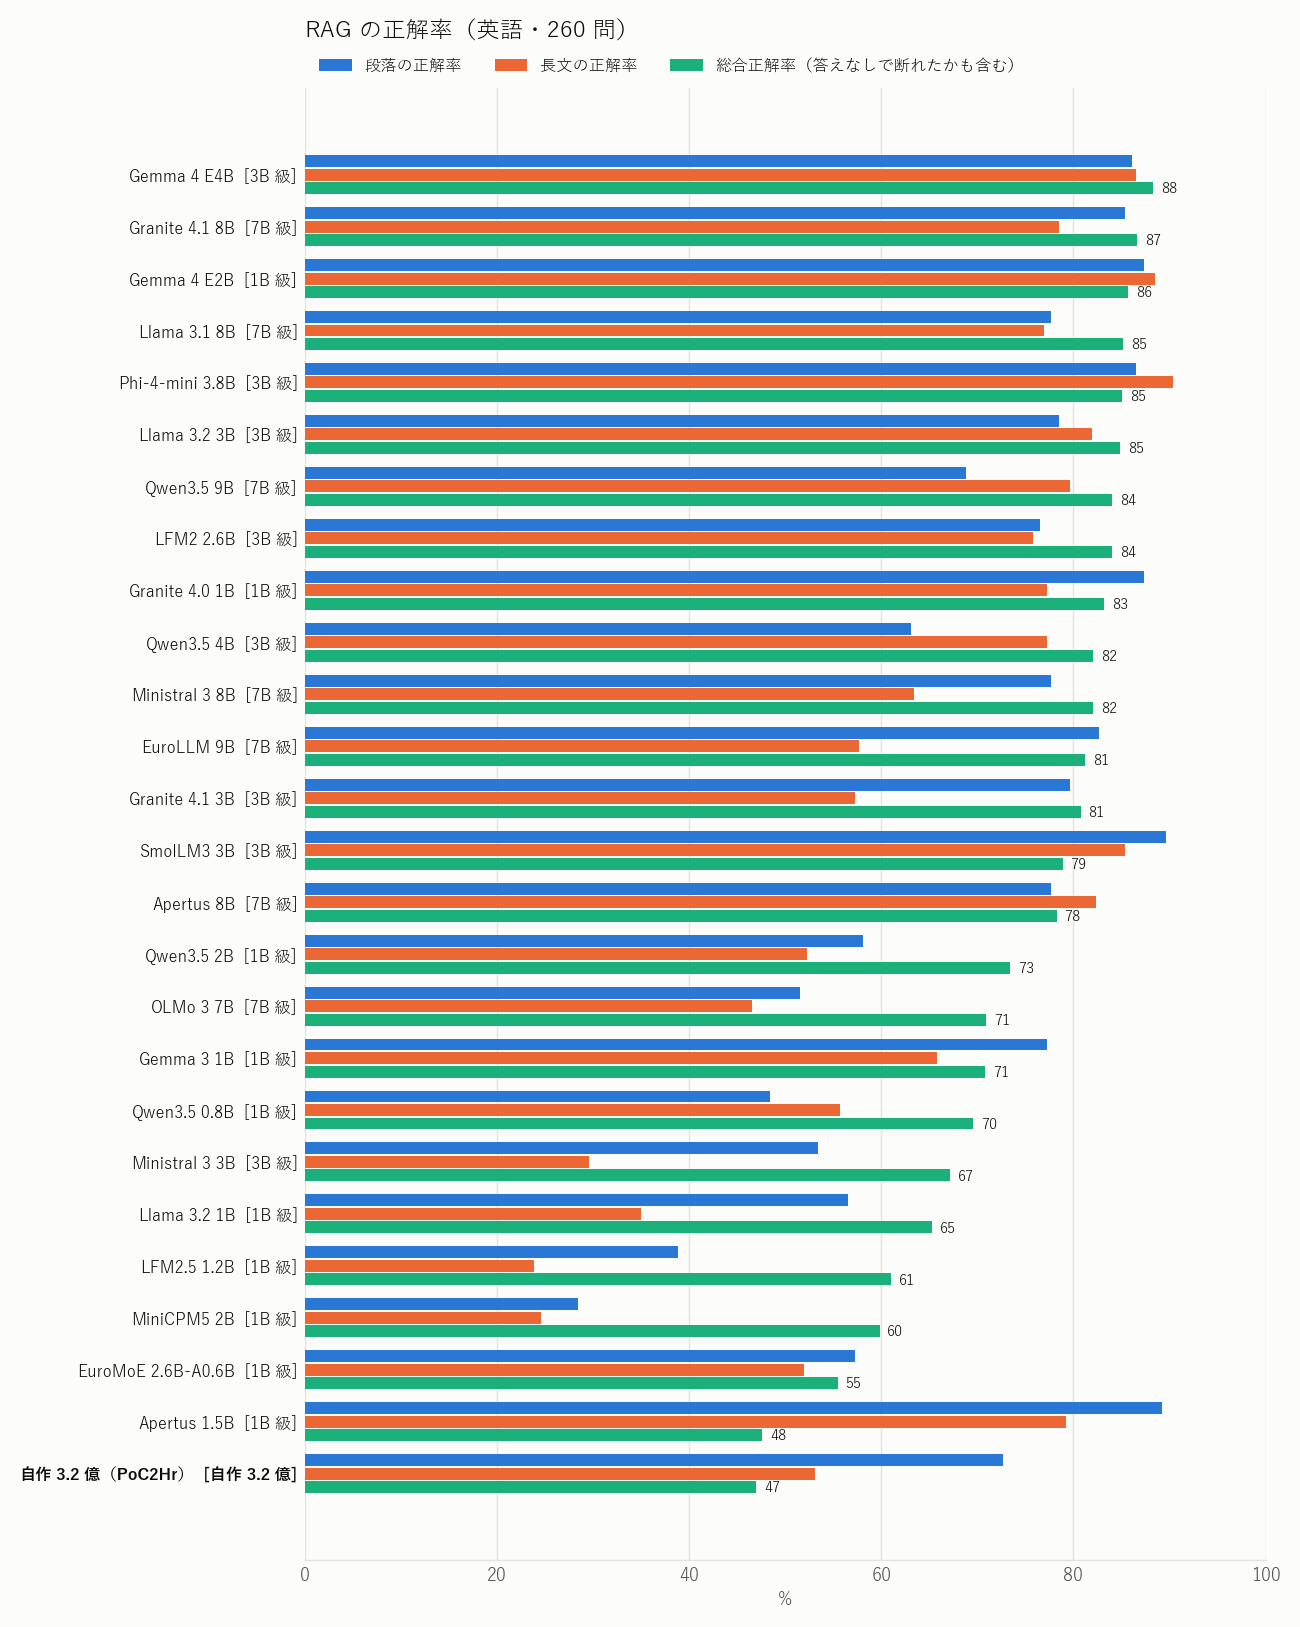
- Prva je Gemma 4 E4B (88%). Gemma 4 E2B također ima 86%, pa je Gemma 4 stabilna na oba jezika
- Nekim modelima rang pada na engleskom. Qwen3.5 4B ide s 90% na hrvatskom na 82% na engleskom. Uzrok je odbijanje odgovora iako on postoji (35% odlomaka)
Što sam saznao 1: razliku čini „može li odbiti odgovor”
Udio slučajeva u kojima je model izmislio odgovor kad dobije dugi tekst bez odgovora (hrvatski).
| Model | Izmišljanje odgovora u dugom tekstu bez odgovora |
|---|---|
| Qwen3.5 4B | 9% |
| Moj model 320M | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
Na primjer, kada se pita „Kada je objavljen Need for Speed Heat?” i da se dugi tekst koji ne sadrži odgovor. Qwen3.5 9B odgovorio je „U tekstu nema odgovora”, dok je Phi-4-mini odgovorio „u kolovozu 1969.”. Izgleda da je pokupio datum koji se nalazio negdje u tekstu.
To je najveći problem kod RAG-a. Opasno je birati model gledajući samo ukupnu točnost. Udio točnih odgovora među danim odgovorima bio je najveći kod Qwen3.5 4B i 9B, 91–92%, dok je Phi-4-mini imao samo 64%.
Što sam saznao 2: na engleskom prečesto odbijaju odgovor
Suprotno tome, na engleskom je mnogo modela odbijalo odgovor iako je on jasno napisan. Udio odbijenih odgovora kada je dan odlomak koji sadrži odgovor.
| Model | Hrvatski | Engleski |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
Na primjer: „Kada je Paul Accola posljednji put stao na postolje?”. U engleskom odlomku jasno piše „the last time in 2000”, ali Qwen3.5 4B odgovorio je „U tekstu nema odgovora”. Kada se isto pitanje postavi na hrvatskom, točno odgovori „2000.”.
Razlog još ne znam. Engleska verzija je strojni prijevod pa možda utječe neprirodnost teksta, a možda model na engleskom prejako reagira na uputu „ako nema odgovora, odgovori ovako”.
Rezultati: brzina na CPU-u
Budući da je moja namjena pokretanje na CPU-u, sve sam modele pretvorio u isti format za llama.cpp (Q4_K_M) i mjerio na i7-13700K. Generiranje je koristilo 8 dretvi, a učitavanje teksta 16 dretvi. Samo Ministral 3 nisam uspio pravilno pretvoriti pa sam upotrijebio službeni Mistralov Q4_K_M.
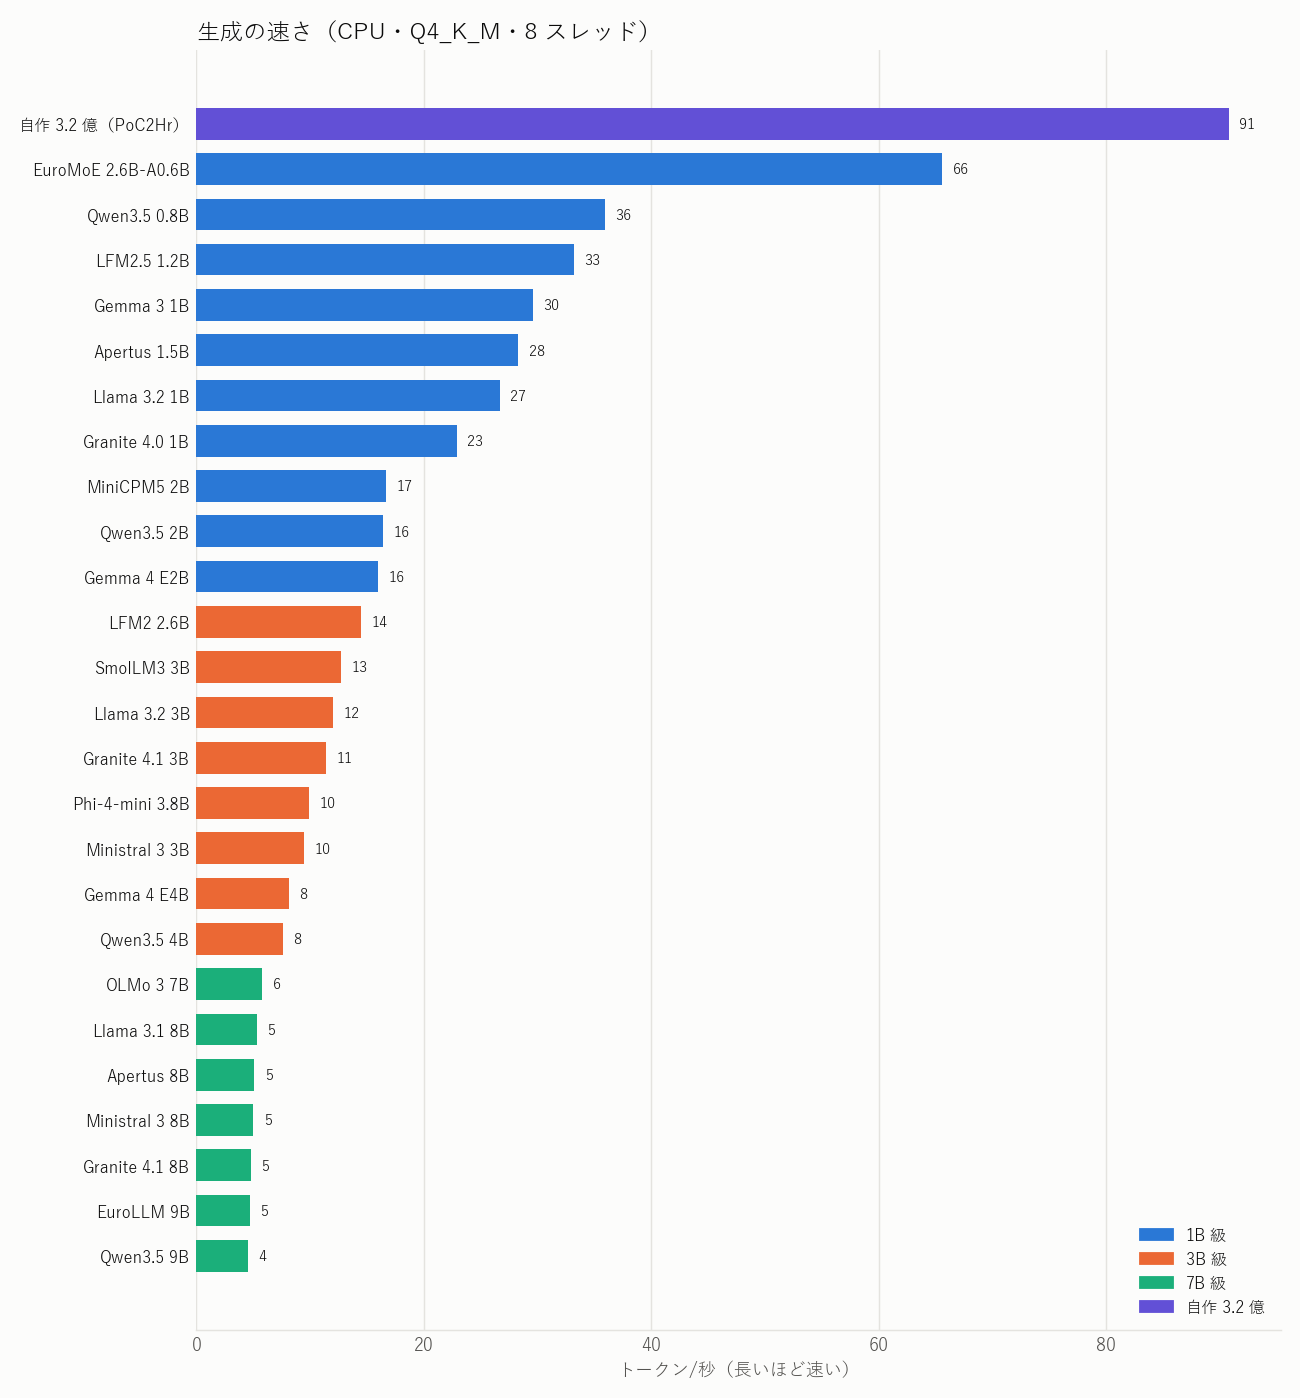
Procijenio sam i vrijeme potrebno za odgovor na jedno pitanje s dugim tekstom: za svaki model zbrojio sam vrijeme učitavanja broja ulaznih tokena dugog teksta i vrijeme generiranja odgovora prosječne duljine.
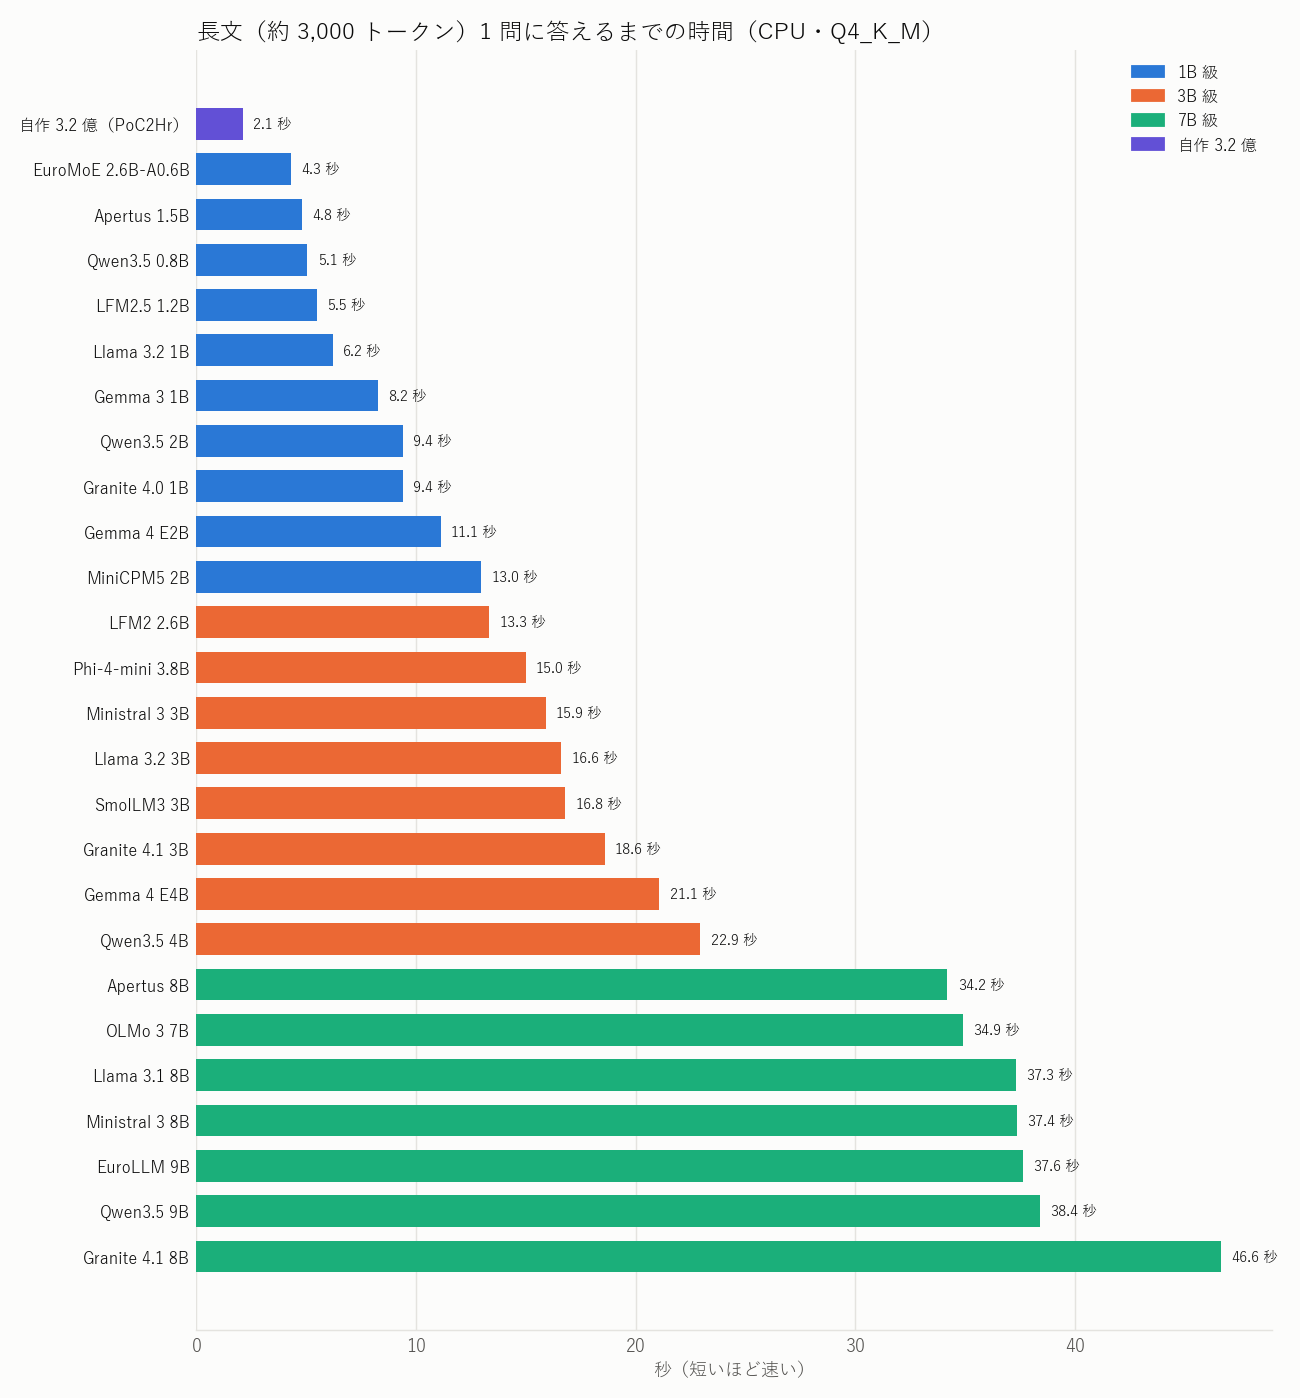
- Brzina generiranja otprilike je obrnuto proporcionalna veličini. Modeli klase 7B generiraju oko 5 tokena u sekundi i za jedno pitanje s dugim tekstom trebaju 34–47 sekundi
- Modeli klase 3B trebaju 13–23 sekunde, a modeli klase 1B 4–13 sekundi
- Čak i za isti dugi tekst, broj ulaznih tokena razlikuje se među modelima, od 2.443 do 3.796. Razlika je u tome koliko tokenizer može sažeto prikazati hrvatski, a vlastiti tokenizer napravljen posebno za hrvatski ima najmanje tokena
Kada se usporede brzina i točnost
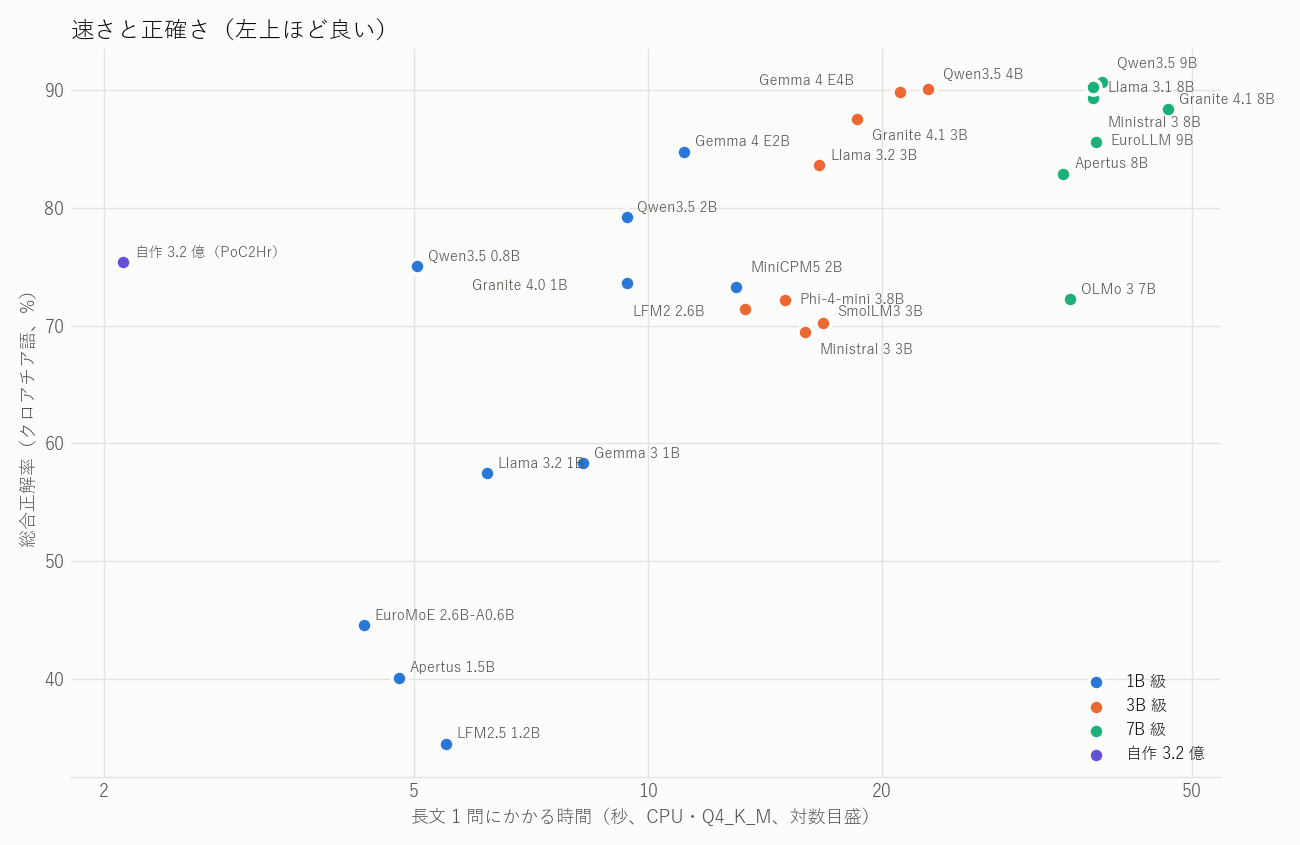
Što je više lijevo i gore, to je „brže i točnije”.
- Najbolji omjer imaju Gemma 4 E2B (11 sekundi, 85%) i Qwen3.5 2B (9 sekundi, 79%)
- Ako je prioritet točnost, odaberite Qwen3.5 4B ili Gemma 4 E4B (21–23 sekunde, 90%). Više su od 1,5 puta brži od klase 7B, uz gotovo jednaku točnost
- Moj model od 320M iznimno je brz (2,1 sekunda). Ukupna točnost od 75% ista je kao kod Qwen3.5 0.8B, a malo izmišljanja odgovora usporedivo je s vodećim modelima. Međutim, točnost na dugim tekstovima iznosi 46%, što je jasno slabije od Qwen3.5 0.8B (75%) i Gemma 4 E2B (88%)
- Budući da moj model nije učio engleski, na engleskom je izmislio odgovor u 91% dugih tekstova bez odgovora
Napomene
- Ocjenjivanje provodi LLM, stoga nije savršeno. Ocjenjivanje je donekle blago
- Engleska verzija je strojni prijevod. I pitanja i prijevode napravio je EuroLLM-9B, što EuroLLM-u možda daje malu prednost (rezultat mu je 86%, otprilike sredina)
- Apertus 1.5B može obraditi samo do 4.096 tokena konteksta pa 23% hrvatskih dugih tekstova nije stalo. Ti su slučajevi ubrojeni kao netočni
- Točnost je mjerena na GPU-u (vLLM, za klasu 7B FP8), a brzina na CPU-u (Q4_K_M), dakle u različitim okruženjima. Kvantizacija bi mogla malo promijeniti točnost
- Brzinu sam mjerio na računalu na kojem su istodobno bile otvorene aplikacije koje inače koristim. Sve sam modele mjerio uzastopno u istim uvjetima pa mislim da se rezultati mogu uspoređivati
Rasprava
- Za RAG je 4B već dovoljno. Najbolji modeli klase 3–4B jednako su točni kao klasa 7–9B, a na CPU-u su 1,5–2 puta brži
- Pri izboru modela obavezno treba provjeriti može li odbiti odgovor. Čak i uz sličnu točnost, udio izmišljenih odgovora u tekstovima bez odgovora razlikuje se od 1% do 99%, ovisno o modelu. U RAG-u pretraga često pronađe nepovezani tekst, pa je ovo najvažniji faktor
- Isti model mijenja ponašanje ovisno o jeziku. Na engleskom je mnogo modela bilo preoprezno i propustilo odgovor. To se ne može znati bez stvarnog testiranja na jeziku koji koristite
- Izazov vlastitog modela su dugi tekstovi. Sposobnost odbijanja i brzina već su dovoljne; ako se poveća točnost na dugim tekstovima, model bi mogao biti vrlo upotrebljiv kao „RAG model koji radi na CPU-u”. To želim sljedeće poboljšati
Naknadno: isprobao sam i modele posebno za RAG
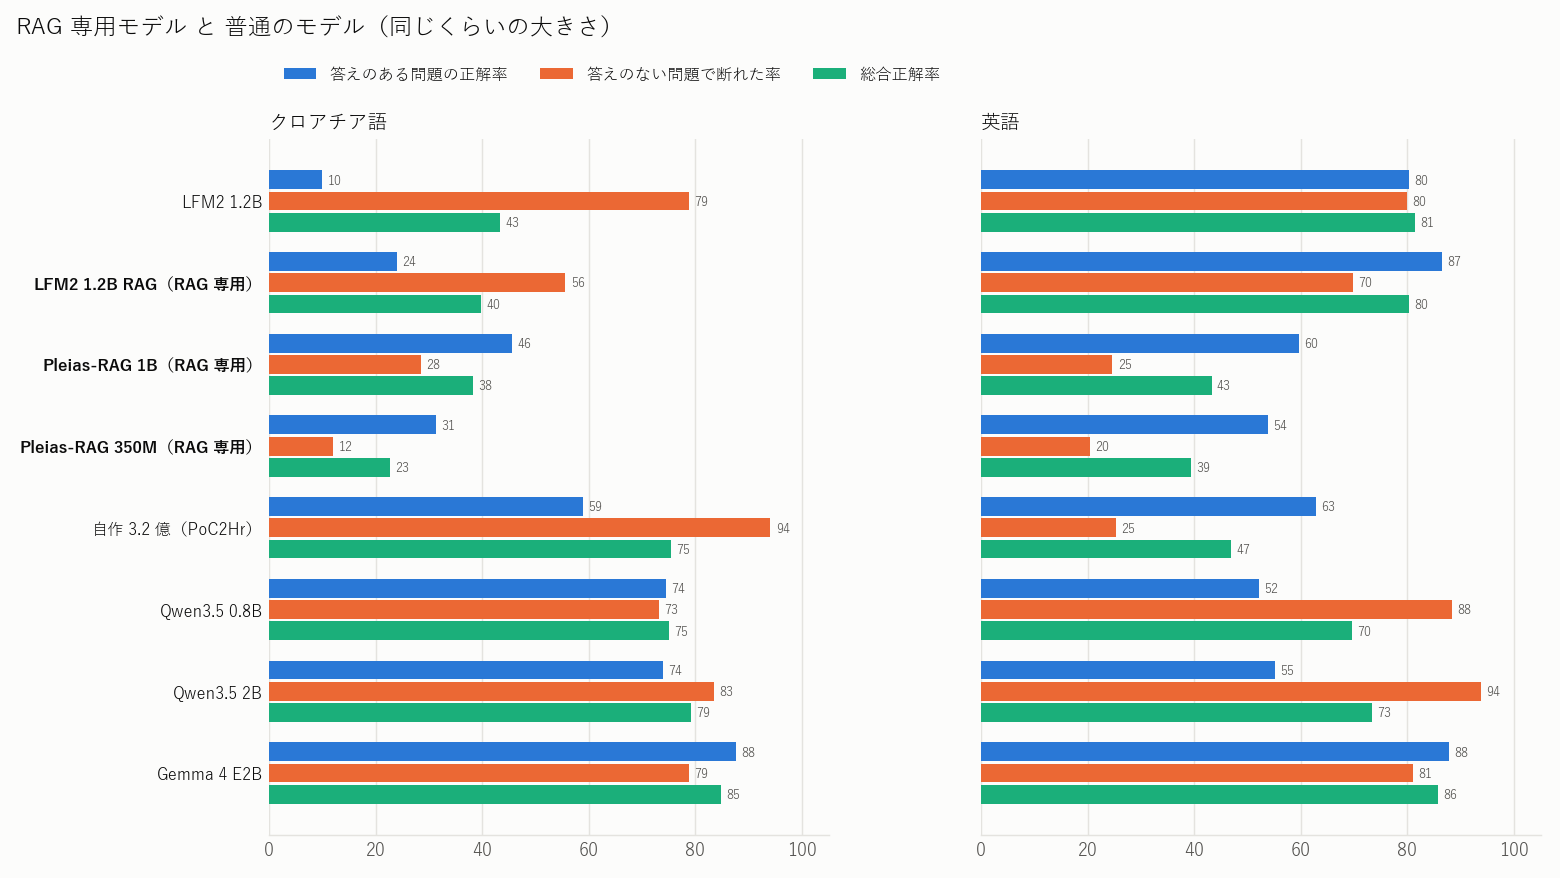
Pitao sam se „Kakvi su modeli posebno prilagođeni za RAG?” pa sam dodatno isprobao tri mala RAG modela. Uvjeti su isti kao gore (istih 260 pitanja, isto ocjenjivanje).
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B dodatno treniran na više od milijun primjera odgovaranja uz priložene dokumente. Podržava devet jezika, uključujući engleski i japanski, ali ne i hrvatski
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): modeli trenirani na približno 3,1 milijun sintetičkih RAG primjera. Prije odgovora pišu „analizu pitanja → analizu izvora → nacrt”, a uz odgovor dodaju citat iz teksta. Podržavaju sedam europskih jezika, ali ne i hrvatski. Mogu obraditi do 4.096 tokena konteksta
- Radi usporedbe izmjerio sam i osnovni LFM2-1.2B iz kojeg je nastao LFM2-1.2B-RAG
LFM2-1.2B-RAG dobio je istu uputu kao ostali modeli. Pleias prihvaća samo vlastiti ulazni format (pitanje i izvore razdvaja posebnim oznakama), pa sam ga zadao u istom obliku kao službena biblioteka i ocjenjivao samo završni dio s odgovorom. Zato Pleiasu nisam mogao dati uputu „ako nema odgovora, odgovori ovako”.
| Model | Ukupno (hrvatski) | Ukupno (engleski) | Izmišljanje u dugom tekstu bez odgovora (hrvatski / engleski) | Vrijeme za jedno pitanje s dugim tekstom (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (osnovni model) | 43% | 81% | 42% / 36% | 7,8 sekundi |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8,1 sekunda |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16,9 sekundi |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6,0 sekundi |
| Referenca: moj model 320M | 75% | 47% | 9% / 91% | 2,1 sekunda |
| Referenca: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5,1 sekunda |
| Referenca: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11,1 sekundi |
Zaključno, u ovim pitanjima nisam pronašao nijednu prednost RAG modela u odnosu na obične modele.
LFM2-1.2B-RAG: počeo je odgovarati, ali je počeo i više izmišljati
U usporedbi s osnovnim LFM2-1.2B na engleskom, točnost na pitanjima koja imaju odgovor porasla je (odlomci 83% → 87%, dugi tekstovi 78% → 86%). Ali povećalo se i izmišljanje odgovora u tekstovima bez odgovora (odlomci 4% → 10%, dugi tekstovi 36% → 51%), pa je ukupni rezultat gotovo isti, 81% → 80%. Čini se da ga je dodatno treniranje za RAG usmjerilo prema tome da „pod svaku cijenu odgovori”.
Hrvatski je bio gotovo neupotrebljiv već kod osnovnog modela. Osnovni LFM2-1.2B odbio je 93% odlomaka s odgovorom riječima „nema odgovora”, a RAG verzija često je kao odgovor doslovno vraćala tekst upute poput „Odgovori kratko, jednom rečenicom.”. Budući da hrvatski nije među podržanim jezicima, to je očekivano.
Pleias-RAG: dodaje citate, ali tih citata nema u tekstu
Pleias gotovo nikada nije odbijao odgovor, čak ni kada ga u tekstu nije bilo. Na engleskom je izmislio odgovor u 78% odlomaka bez odgovora i 73% dugih tekstova bez odgovora (1B).
Upitan je i njegov navodni adut, „odgovori s citatima”. Izbrojao sam udio slučajeva u kojima se rečenica citata može pronaći doslovno u tekstu (potpuno podudaranje uz zanemarivanje samo razlika u razmacima, stoga su i malo preoblikovani citati ubrojeni kao „nisu pronađeni”).
| Pitanja s odgovorom | Pitanja bez odgovora | |
|---|---|---|
| Pleias-RAG 1B (engleski) | 64% | 42% |
| Pleias-RAG 1B (hrvatski) | 57% | 53% |
| Pleias-RAG 350M (engleski) | 66% | 39% |
| Pleias-RAG 350M (hrvatski) | 52% | 40% |
Na primjer: „Koji je bend prvi napisao pjesmu Tourniquet?” (odgovor je Soul Embraced).
- Kada dobije odlomak koji ne sadrži odgovor, 1B odgovara „Amy Lee ju je napisala” i dodaje rečenicu koja ne postoji u tekstu kao citat: „Amy Lee (born Amy Leigh Lee, November 1, 1970) ...”
- Čak i kada dobije odlomak s odgovorom, odgovara „Amy Lee ju je napisala”. Pritom dodani citat glasi „originally written ... for the Christian death metal band Soul Embraced”, pa je citat točan, ali odgovor mu proturječi
S citatom odgovor izgleda kao da se stvarno temelji na tekstu, što ga čini čak i opasnijim.
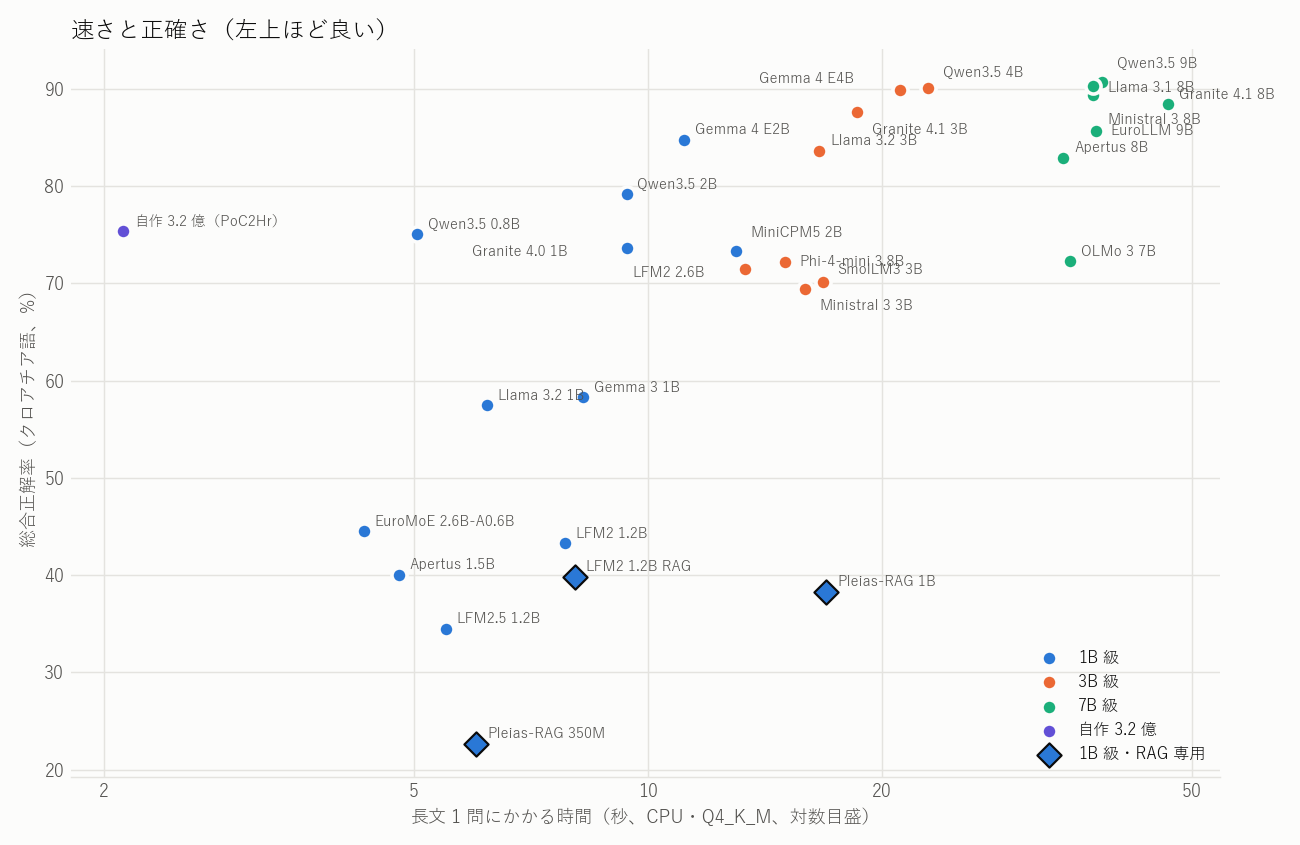
I po brzini Pleias zaostaje jer prije odgovora piše analizu, pa su odgovori dugi (u prosjeku 381–420 tokena za duge tekstove). Modelu 1B za jedno pitanje s dugim tekstom treba 16,9 sekundi, što je sporije od Gemma 4 E2B (11,1 sekundi). Osim toga, 25% hrvatskih dugih tekstova nije stalo u kontekst (ubrojeni su kao netočni; vrijeme je prosjek samo za pitanja koja su stala, pa je u stvarnosti nešto dulje).
Zašto se to dogodilo? (pretpostavke)
- Jezik: hrvatski nije među podržanim jezicima ni jednog od ova tri modela. No gube od običnih modela i na engleskom
- Oblik pitanja: ovdje je riječ o zadacima „kratko odgovori iz jednog teksta / odbij ako nema odgovora”. Pleias se ocjenjuje na zadacima koji traže kombiniranje više izvora za odgovor (poput HotpotQA), pa mu možda više odgovara drugačiji oblik
- Način odbijanja: običnim modelima može se zadati „ako nema odgovora, odgovori ovako”, ali Pleiasu nema mjesta za takvu uputu. Sam model ima mehanizam za procjenu da „iz ovih izvora nije moguće odgovoriti”, ali ovdje gotovo nije djelovao
Sažetak naknadnog testa
- Ne treba birati samo prema nazivu „posebno za RAG”. U ovim uvjetima obični instrukcijski modeli poput Gemma 4 E2B i Qwen3.5 bili su točniji i odbijali odgovor kad je trebalo
- Odgovor s citatom nema smisla bez provjere samog citata. Samo se 40–70% Pleiasovih citata moglo pronaći doslovno u tekstu
- Moj model bolji je od RAG modela slične veličine. U usporedbi s Pleias-RAG 350M, ukupni rezultat na hrvatskom je 75% naspram 23%, a vrijeme za jedno pitanje s dugim tekstom 2,1 sekunda naspram 6,0 sekundi. Imalo je smisla izraditi ga posebno za hrvatski
Brzinu četiri dodatna modela izmjerio sam iste večeri, na istom računalu i pod istim uvjetima. Dodao sam ih i na graf brzine i točnosti.
Svi rezultati
Hrvatski
| Model | Klasa | Točno (odlomak) | Točno (dugi tekst) | Ukupno | Izmišljanje odgovora kada odgovora nema (odlomak/dugi tekst) | Udio točnih među danim odgovorima |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | klasa 7B | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | klasa 7B | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | klasa 3B | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | klasa 3B | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | klasa 7B | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | klasa 7B | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | klasa 3B | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | klasa 7B | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | klasa 1B | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | klasa 3B | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | klasa 7B | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | klasa 1B | 74% | 74% | 79% | 4% / 29% | 79% |
| Vlastiti 320 M | vlastiti | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | klasa 1B | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | klasa 1B | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | klasa 1B | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | klasa 7B | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | klasa 3B | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | klasa 3B | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | klasa 3B | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | klasa 3B | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | klasa 1B | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | klasa 1B | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | klasa 1B | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | klasa 1B | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | klasa 1B | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | klasa 1B · samo za RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | klasa 1B · samo za RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | klasa 1B | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | klasa 1B · samo za RAG | 54% | 9% | 23% | 85% / 68% | 21% |
Engleski
| Model | Klasa | Točno (odlomak) | Točno (dugi tekst) | Ukupno | Izmišljanje odgovora kada odgovora nema (odlomak/dugi tekst) | Udio točnih među danim odgovorima |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | klasa 3B | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | klasa 7B | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | klasa 1B | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | klasa 7B | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | klasa 3B | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | klasa 3B | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | klasa 3B | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | klasa 7B | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | klasa 1B | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | klasa 7B | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | klasa 3B | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | klasa 7B | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | klasa 3B | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | klasa 1B | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | klasa 1B · samo za RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | klasa 3B | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | klasa 7B | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | klasa 1B | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | klasa 7B | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | klasa 1B | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | klasa 1B | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | klasa 3B | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | klasa 1B | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | klasa 1B | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | klasa 1B | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | klasa 1B | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | klasa 1B | 89% | 79% | 48% | 93% / 97% | 47% |
| Vlastiti 320 M | vlastiti | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | klasa 1B · samo za RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | klasa 1B · samo za RAG | 63% | 44% | 39% | 67% / 92% | 34% |
Brzina na CPU-u (i7-13700K · llama.cpp Q4_K_M)
| Model | Veličina | Generiranje (tokena/s) | Učitavanje (tokena/s) | Broj ulaznih tokena za dugi tekst | Vrijeme za jedno pitanje o dugom tekstu |
|---|---|---|---|---|---|
| Vlastiti 320 M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 s |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 s |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 s |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 s |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 s |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 s |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 s |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 s |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 s |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 s |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 s |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 s |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 s |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 s |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 s |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 s |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 s |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 s |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 s |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 s |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 s |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 s |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 s |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 s |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 s |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 s |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 s |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 s |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 s |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 s |
※ Za Apertus 1.5B i Pleias-RAG riječ je o prosjeku samo za duge tekstove koji su stali u kontekst od 4.096 tokena。