Kvantizirao sam vlastiti LLM s 300 milijuna parametara i usporedio brzinu i točnost na CPU-u
Model s 320 milijuna parametara za hrvatski RAG koji sam napravio u prethodnom članku. Budući da je namijenjen radu na CPU-u, ovaj put sam ga kvantizirao kako bih provjerio koliko se može smanjiti i ubrzati te koliko pritom pada točnost.
Zaključak ukratko.
- Q6_K je taman. Pet puta je manji (254 MB), generira približno četiri puta brže, a točnost je jednaka izvornoj verziji modela
- Q2_K se raspada. Brz je, ali i na pitanja za koja odgovor postoji tvrdi da „nema odgovora”
- Neočekivano, Q3_K_M bio je točniji od Q4_K_M
Što sam napravio
Model izrađen u PyTorchu pretvorio sam u oblik koji se može pokretati u llama.cpp (GGUF), alatu koji se često koristi za CPU inferenciju, te ga spremio u osam različitih preciznosti.
- Model sam izvezao u istom formatu kao Qwen3 i pretvorio u GGUF
- Budući da je tokenizer vlastiti, llama.cpp je odbio pretvorbu kao za „nepoznati tokenizer”. Usporedio sam pravila razdvajanja riječi i utvrdio da su potpuno ista kao u Qwen2, pa sam ga registrirao kao Qwen2 i tako prošao pretvorbu
- Provjerio sam je li pretvorba ispravna. Tokenizacija svih 160 tekstova potpuno se podudarala s verzijom u PyTorchu. Zatim sam na 20 pitanja generirao odgovor uvijek birajući riječ s najvećom vjerojatnošću; i izlazi su se potpuno podudarali za svih 20 pitanja
- S pomoću
llama-quantizeizradio sam verzije od F16 do Q2_K
Dakle, F32 u tablici sadržajno je jednak verziji u PyTorchu. To je referentna točka usporedbe.
Metoda mjerenja
- CPU je i7-13700K. GPU nisam koristio
- Postavke llama.cpp-a bile su 8 niti za generiranje i 16 niti za učitavanje teksta (testiranjem se pokazalo da je to najbrže)
- Za 100 evaluacijskih pitanja i 4 vrste konteksta svaki je model odgovorio ukupno 400 puta
- Odlomak: odlomak od oko 100 tokena koji sadrži odgovor
- Dugačak tekst: tekst od oko 3.000 tokena koji sadrži odgovor (uz dodane nepovezane članke)
- Bez odgovora (odlomak / dugačak tekst): tekst koji ne sadrži odgovor. Ispravno je ako model odbije odgovoriti
- U prethodnom članku mjerenje je provedeno na 300 pitanja, pa se brojke malo razlikuju
Rezultati: točnost
| Format | Veličina | Točno: odlomak | Točno: dugačak tekst | Odbio: dugačak tekst | Izmišljanje (bez odgovora: odlomak/dugačak tekst) | Točnost nakon provjere |
|---|---|---|---|---|---|---|
| F32 (referenca) | 1.233 MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| F16 | 617 MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| Q8_0 | 329 MB | 76% | 53% | 30% | 1% / 8% | 81,9% |
| Q6_K | 254 MB | 79% | 54% | 30% | 2% / 9% | 81,3% |
| Q5_K_M | 223 MB | 72% | 45% | 41% | 1% / 6% | 84,4% |
| Q4_K_M | 193 MB | 68% | 37% | 46% | 1% / 7% | 75,9% |
| Q3_K_M | 160 MB | 72% | 48% | 38% | 1% / 8% | 80,4% |
| Q2_K | 129 MB | 39% | 11% | 78% | 4% / 7% | 72,2% |
„Točnost nakon provjere” označava udio točnih odgovora nakon što je program provjerio nalazi li se modelov citat doista u tekstu; ako ga nema, odgovor se zamjenjuje s „nema odgovora”.
- F16, Q8_0 i Q6_K gotovo su jednaki referenci. Razlika je samo jedno ili dva pitanja
- Od Q5_K_M naniže ne povećava se toliko broj pogrešaka koliko broj odbijanja odgovora. Čini se da se zadržala osobina koju sam model prethodno naučio: kad nije siguran, odbije odgovoriti. Izmišljanje se nije povećalo
- Q4_K_M je lošiji od Q3_K_M. Na dugačkim tekstovima rezultat je 37% naspram 48%. Uz 100 pitanja ima određene varijacije, ali 11 postotnih bodova velika je razlika. Razlog još nisam istražio
- Q2_K odbija odgovoriti na 78% dugačkih tekstova. To je već drugi model
Rezultati: brzina
| Format | Brzina generiranja | Prosječno vrijeme po upitu |
|---|---|---|
| PyTorch fp32 (za usporedbu) | odlomak 14,6 · dugačak tekst 6,7 tok/s | — |
| F32 | 18,7 tok/s | 2,76 s |
| F16 | 35,9 tok/s | 2,08 s |
| Q8_0 | 59,0 tok/s | 1,93 s |
| Q6_K | 73,1 tok/s | 1,33 s |
| Q5_K_M | 81,2 tok/s | 1,26 s |
| Q4_K_M | 89,1 tok/s | 1,10 s |
| Q3_K_M | 103,4 tok/s | 1,12 s |
| Q2_K | 119,9 tok/s | 1,07 s |
Brojke za llama.cpp prosjeci su 400 pokretanja (zajedno za odlomke, dugačke tekstove i slučajeve bez odgovora). Brojke za PyTorch izmjerene su u prethodnom članku.
- Brzina generiranja je gotovo obrnuto proporcionalna veličini. Na CPU-u brzinu određuje čitanje težina iz memorije, više nego samo računanje, pa je manji model brži
- Čak je i pri istoj F32 preciznosti llama.cpp brži od PyTorcha
- No od Q6_K naniže vrijeme po upitu ne smanjuje se mnogo. Pri ovoj duljini većinu vremena zauzima početno učitavanje teksta
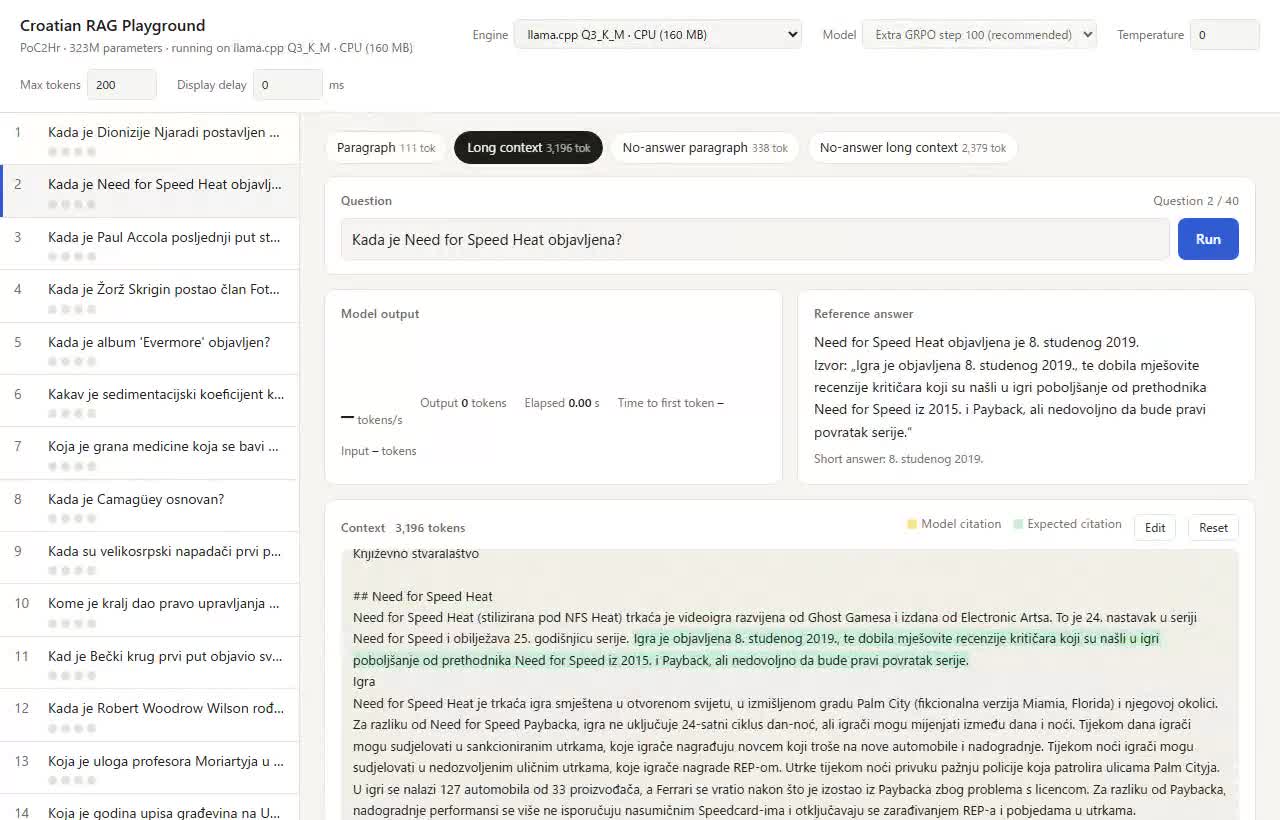
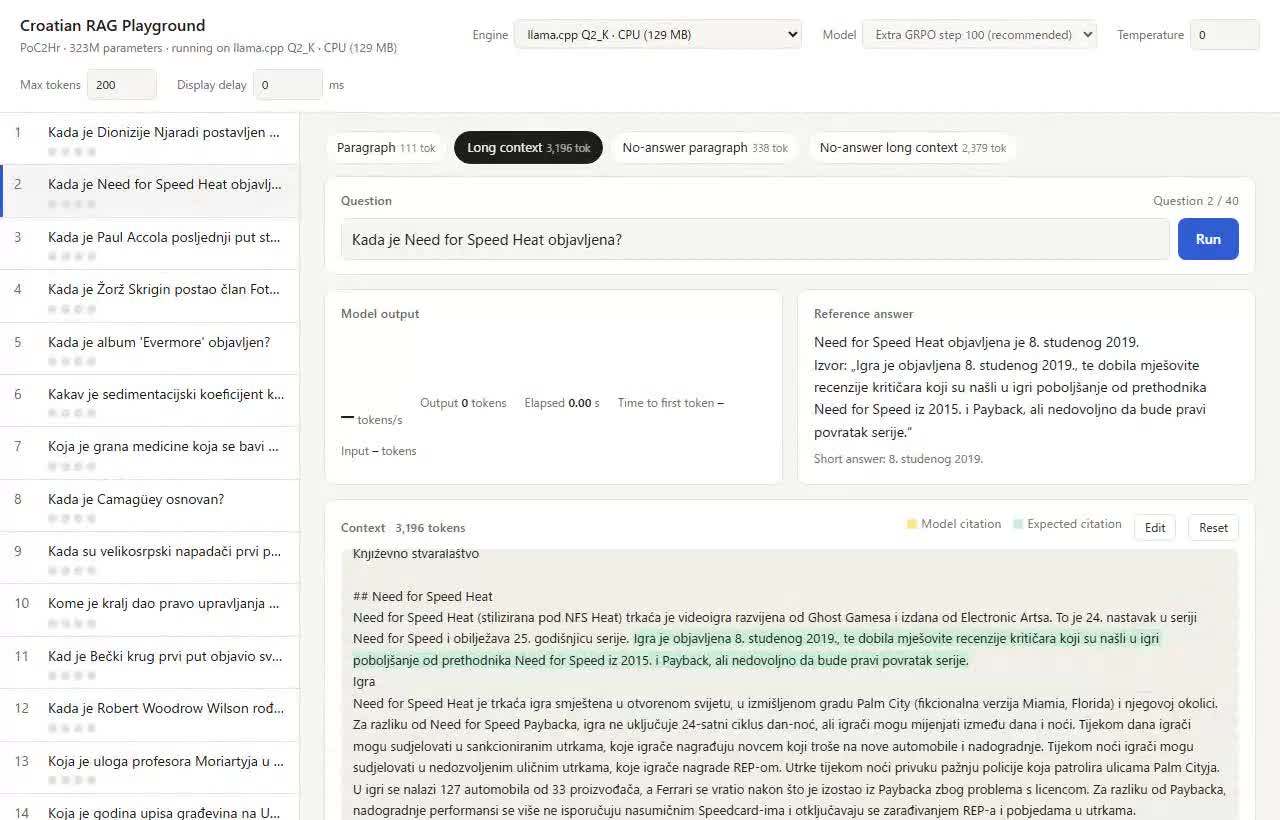
Video: isto pitanje iz dugačkog teksta riješeno na CPU-u
Modelu sam dao tekst od oko 3.200 tokena i postavio pitanje: „Kada je objavljen Need for Speed Heat?” Točan odgovor je 8. studenoga 2019.
Video je sniman dok je model radio, a preglednik istodobno iscrtavao zaslon, pa su brzine u videu manje od onih u gornjoj tablici. Pogledajte ga kao usporedbu jedne verzije uz drugu.
| Format | Brzina generiranja u videu | Do prvog znaka | Ukupno | Rezultat |
|---|---|---|---|---|
| PyTorch fp32 | 5,5 tok/s | 4,8 s | 18,5 s | Točno |
| F32 | 14,2 tok/s | 2,8 s | 8,1 s | Točno |
| F16 | 25,9 tok/s | 3,5 s | 6,4 s | Točno |
| Q8_0 | 38,2 tok/s | 4,0 s | 5,9 s | Točno |
| Q6_K | 41,6 tok/s | 2,6 s | 4,4 s | Točno |
| Q5_K_M | 46,3 tok/s | 2,6 s | 4,3 s | Točno |
| Q4_K_M | 47,2 tok/s | 2,3 s | 4,7 s | Točno (odgovor je dulji) |
| Q3_K_M | 56,7 tok/s | 2,5 s | 4,5 s | Točno (odgovor je dulji) |
| Q2_K | 61,3 tok/s | 2,7 s | 2,8 s | Odbio odgovoriti |
Od F32 do Q5_K_M odgovor i citat potpuno su jednaki verziji u PyTorchu. Q4_K_M i Q3_K_M dali su dulju rečenicu odgovora, ali citat je bio točan. Q2_K je, iako odgovor postoji, odbio odgovoriti uz tvrdnju: „U tekstu nema odgovora.”
PyTorch fp32 (izvorni model)
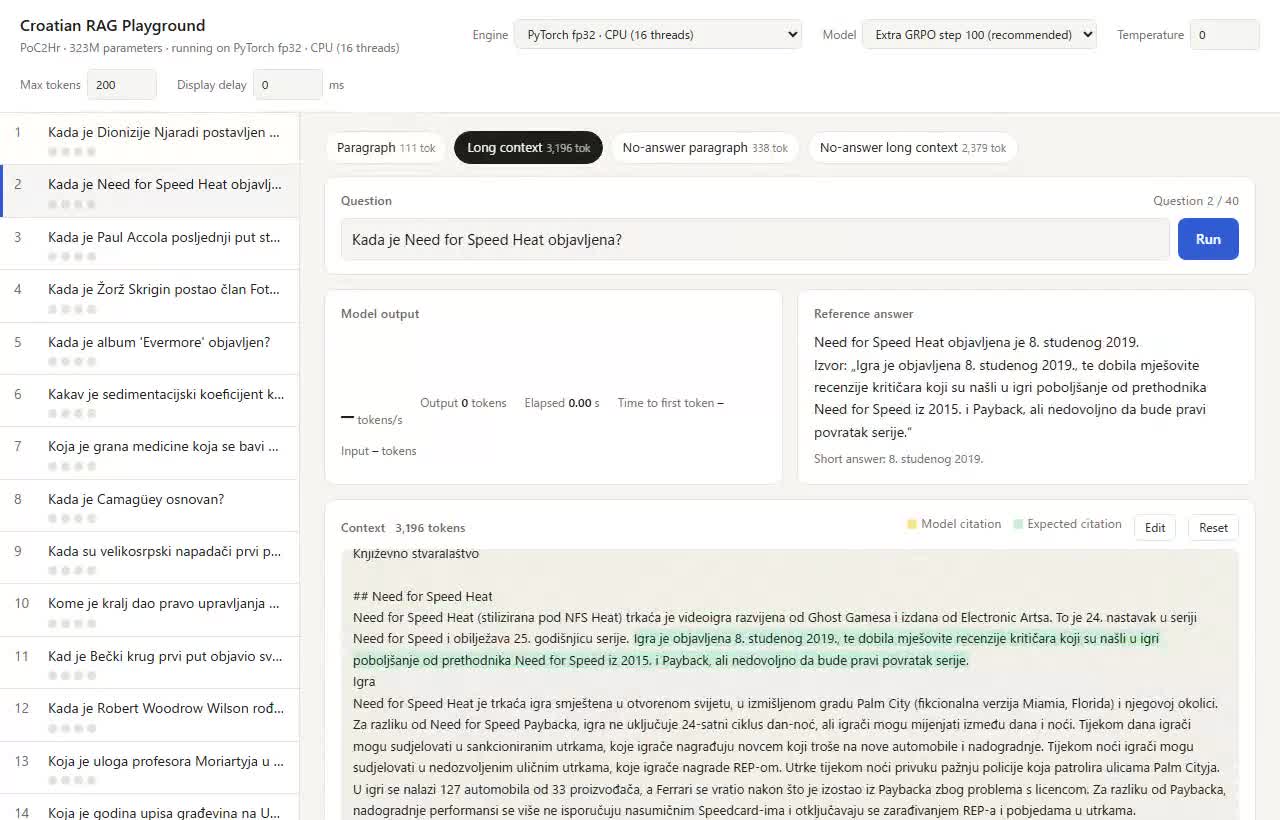
llama.cpp F32 (1.233 MB)
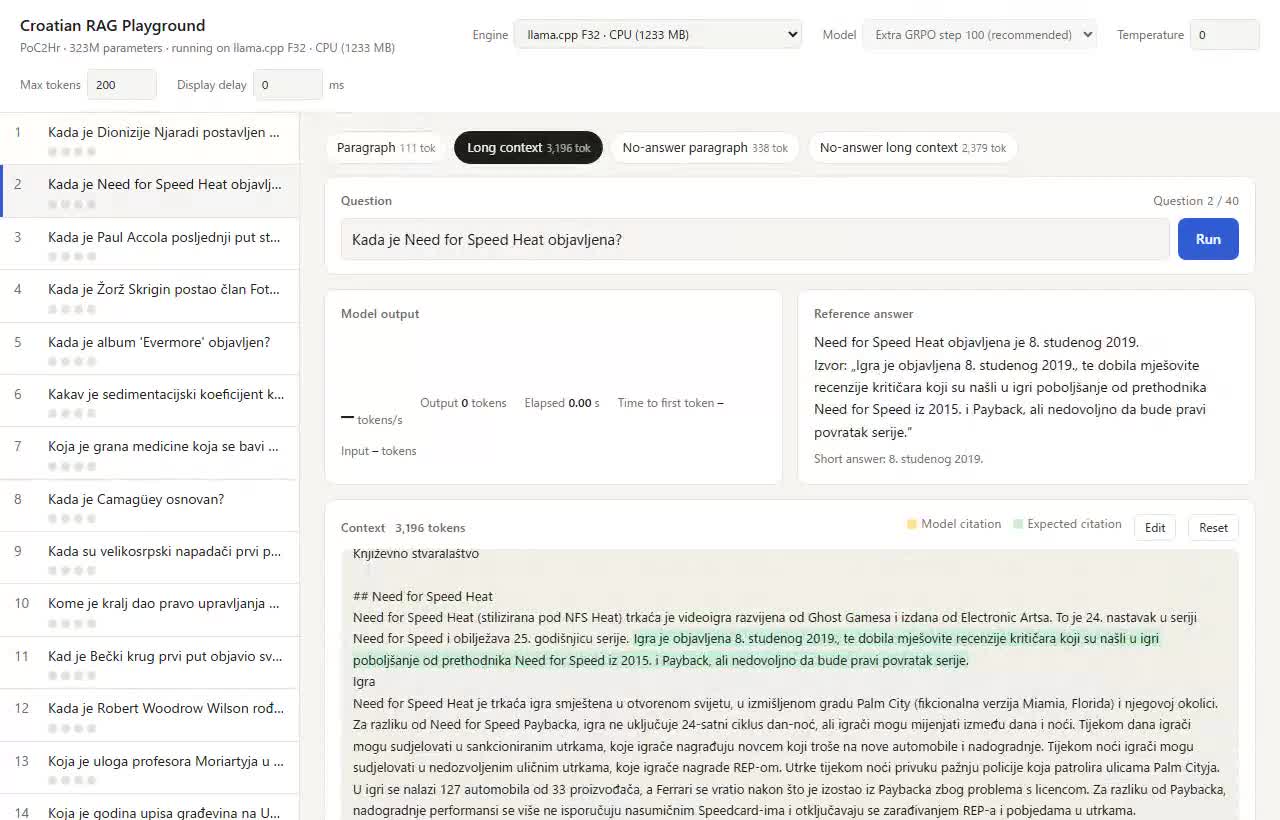
llama.cpp F16 (617 MB)
llama.cpp Q8_0 (329 MB)
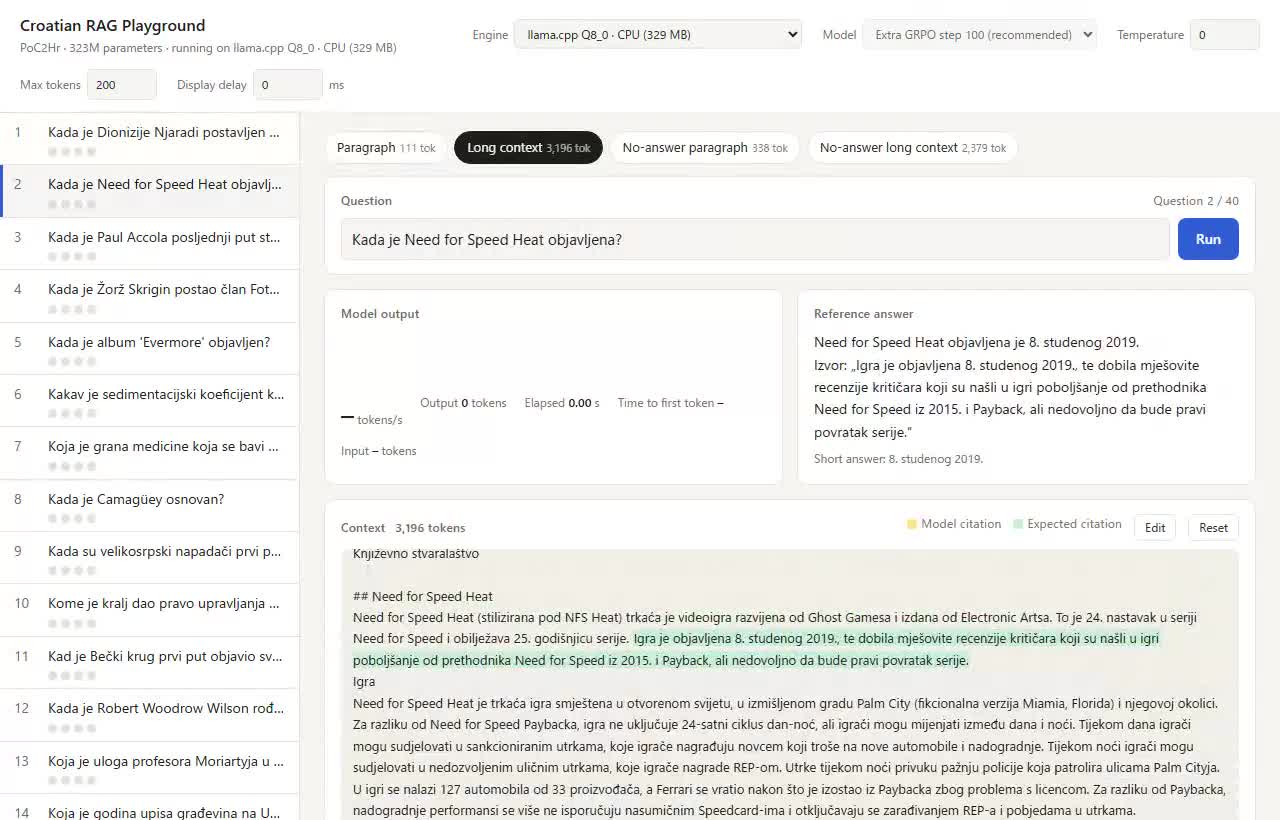
llama.cpp Q6_K (254 MB)
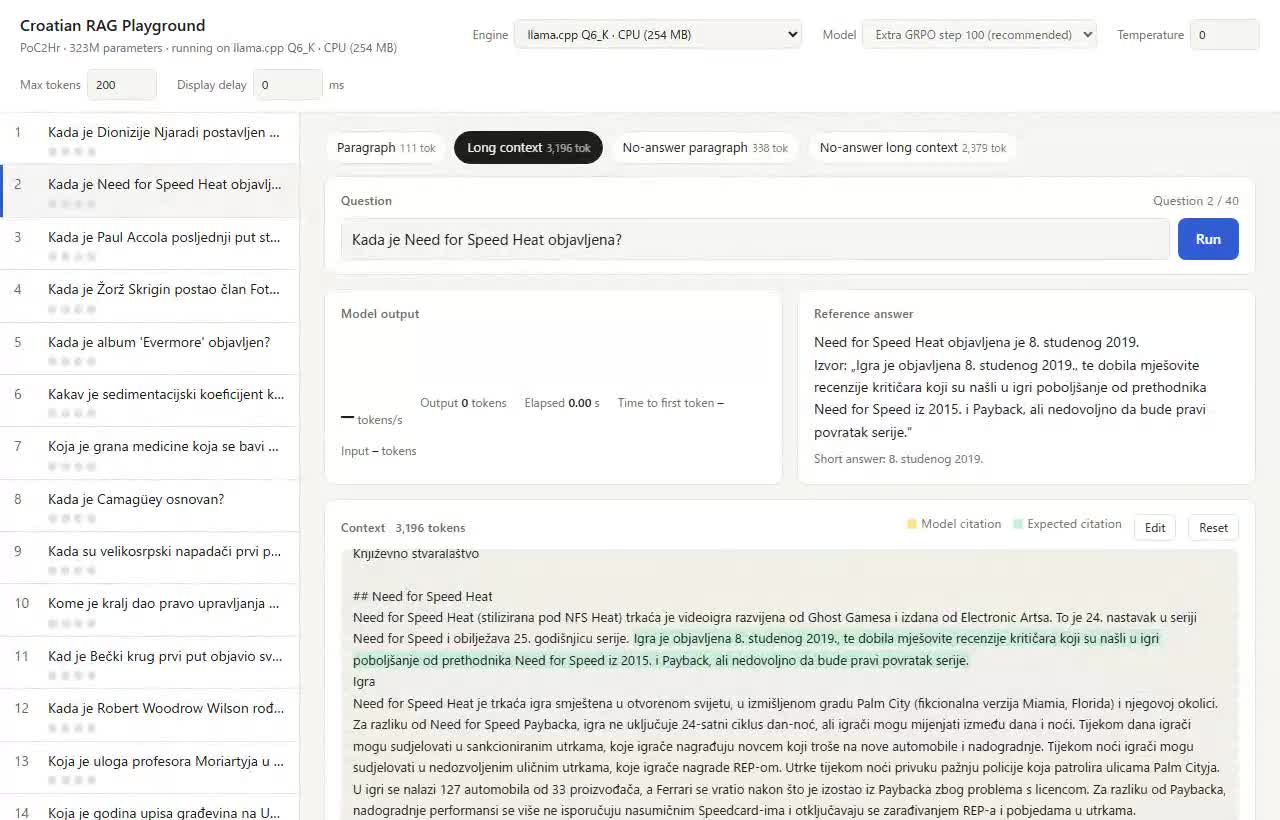
llama.cpp Q5_K_M (223 MB)
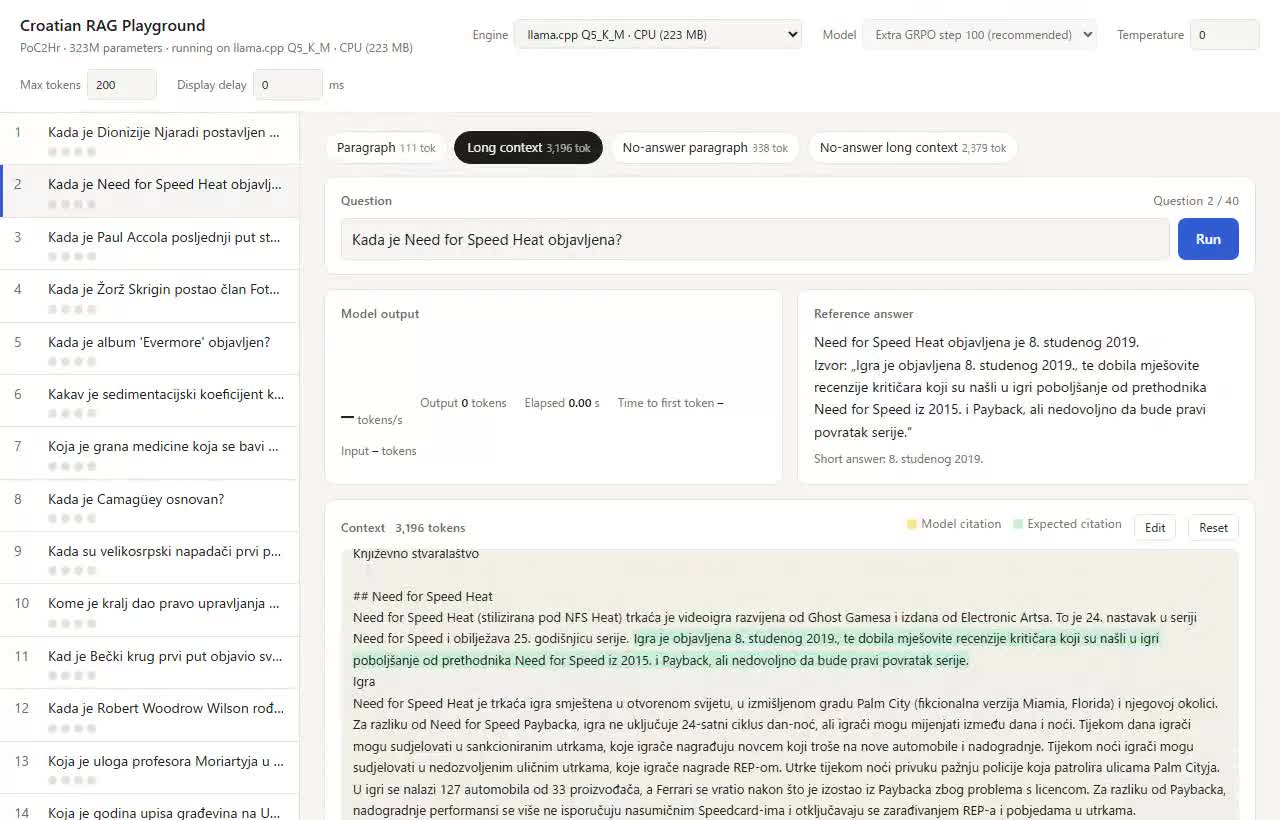
llama.cpp Q4_K_M (193 MB)
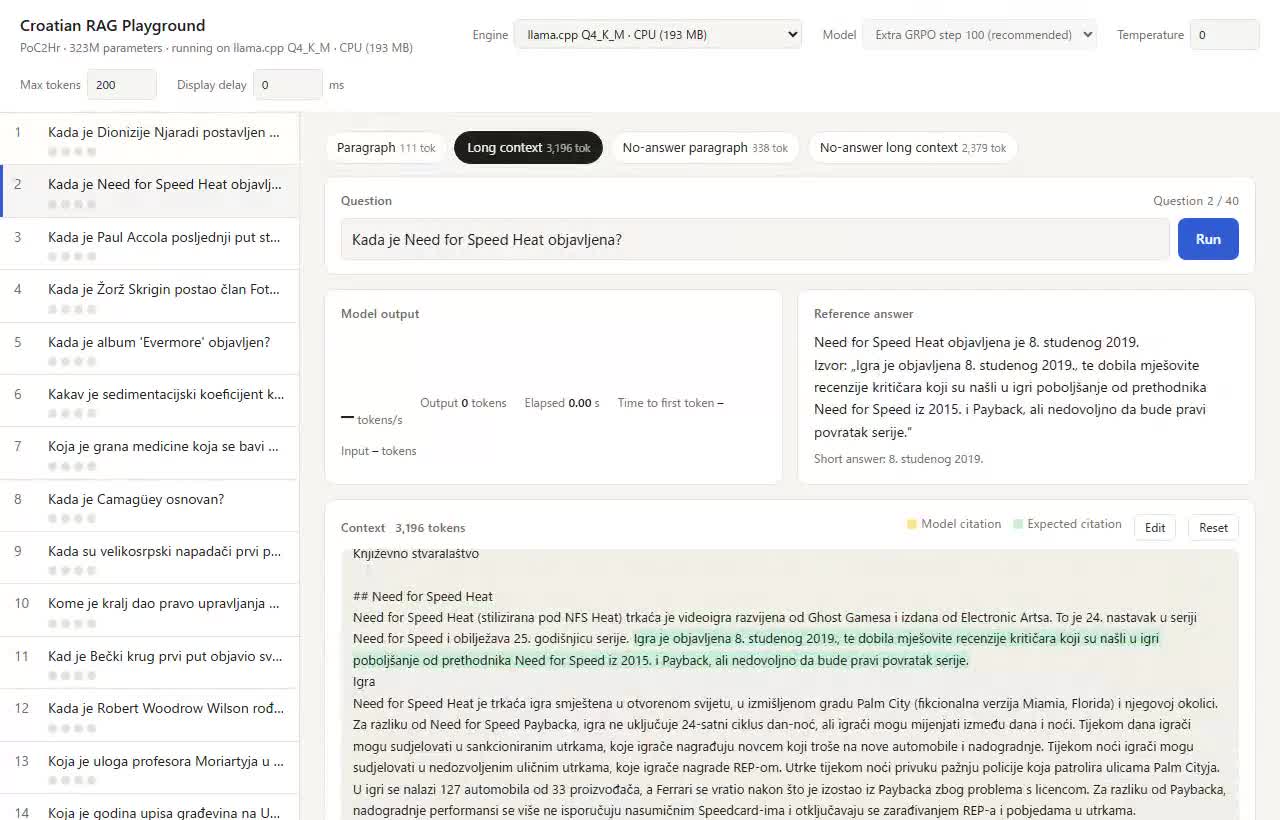
llama.cpp Q3_K_M (160 MB)
llama.cpp Q2_K (129 MB)
Zaključci
- Ako ovaj model pokrećete na CPU-u, odaberite Q6_K. Točnost je ista kao kod izvornika, model je pet puta manji, a generiranje je oko pet puta brže od PyTorcha. Nema razloga za dvojbu
- Za dodatnu sigurnost odaberite Q8_0. Gotovo je jednak izvorniku i ima 329 MB. I dalje je dovoljno malen
- Mali modeli s 300 milijuna parametara osjetljivi su na kvantizaciju. Za veće modele kaže se da se ni pri Q4 gotovo ne vide gubici, no ovdje je pad od Q5 nadalje bio očit. Model već nema mnogo rezerve, pa se smanjivanje osjeti
- Dobro je što se kvar manifestira odbijanjem odgovora. Za RAG je sigurnije odbiti nego povećati broj izmišljenih odgovora. Učinak prethodnog učenja odbijanja odgovora pomoću potkrepljujućeg učenja vidi se i ovdje
- Kod malih modela razlike u brzini se smanjuju. Od Q6_K naniže, čak i ako generiranje postaje brže, ostaje vrijeme za učitavanje teksta pa se u praksi razlika jedva osjeti. I u videu su Q6_K do Q3_K_M svi bili oko četiri sekunde
- Još ne znam zašto je Q4_K_M izgubio od Q3_K_M. Želio bih to istražiti s više pitanja i provjerom koji se slojevi kako kvantiziraju