Napravio sam hrvatski model za sintezu govora s 32 milijuna parametara: usporedba glasova tijekom učenja
Nakon LLM-a za hrvatski RAG, ovaj put sam pokušao napraviti mali model za sintezu govora (TTS) posebno za hrvatski jezik. Cilj je da radi u stvarnom vremenu na CPU-u pametnog telefona.
Pristup je bio „destilacija”. Veliki model za sintezu govora (HiggsAudio v3) čitao je hrvatske scenarije i tako je nastao skup podataka za učenje, a zatim sam mali model trenirao od nule. Ovaj put prvo sam proveo probno učenje na 7,5 sati podataka i usporedio kako se ista rečenica mijenja tijekom učenja.
Zaključak odmah na početku.
- S 32 milijuna parametara (Matcha-TTS 18,3 milijuna + Vocos 13,5 milijuna), model doista govori hrvatski
- Već nakon 50 minuta učenja (5.000 koraka) čitao je prema scenariju. Nakon toga se uglavnom poboljšavao „šum”
- Stopa pogrešaka znakova za 14 evaluacijskih rečenica na kraju je bila 0,9 % (10 od 14 rečenica savršeno se podudaralo)
- Čak je i s jednim CPU dretvom mogao stvoriti sekundu zvuka za 0,09 sekundi (i7-13700K)
Demonstracija: neka stvarno progovori
Na hrvatsko TTS igralište postavio sam model iz ovog članka (konačnu verziju s 30.000 koraka). Upišite bilo koji hrvatski tekst i odmah će ga pročitati naglas.
- Možete odabrati među 50 oglednih rečenica (pozdravi, putovanja, bolnica itd.) ili sami unijeti do 1.000 znakova
- Možete mijenjati brzinu govora, jačinu intonacije i broj koraka sinteze. Ako fiksirate seed, ista će rečenica svaki put dati isti zvuk
- Sinteza radi isključivo na CPU-u poslužitelja (ONNX Runtime; ne koristi ni GPU ni vanjski API)
- Ne zna čitati brojeve, pa ih treba zapisati riječima, primjerice „dvadeset pet (25)”
Što sam napravio
1. Izrada scenarija: lokalnoj Gemmi 4 31B zadao sam da piše replike svakodnevnih razgovora na hrvatskom. Nasumično sam određivao situaciju, sugovornika, emociju i duljinu, poput „razgovara s bakom na tržnici” ili „uplašena je jer je usred noći čula čudan zvuk”, po 22 retka odjednom. Zamišljeni govornik bila je jedna žena u tridesetima. Pomiješao sam 23 vrste emocija (neutralno, radost, ljutnja, šapat i slično).
2. Pretvaranje u zvuk: HiggsAudio v3 čitao je scenarije glasom iz referentne snimke (16 sekundi). Kada se dodaju oznake emocija (poput <|emotion:anger|>), glas se doista naljuti ili razveseli. Izradio sam 4.500 snimaka za otprilike 5 sati.
3. Automatska provjera: Whisper large-v3 prepisao je snimke, a zatim sam ih usporedio sa scenarijima i odbacio pogrešno pročitane. Uz to sam modelom za prepoznavanje govornika mjerio sličnost glasa s referentnom snimkom te odbacio i one kojima se glas promijenio. Prošlo je 4.393 od 4.500 snimaka (97,6 %). Nakon rezanja tišine na početku i kraju ostalo je 7,46 sati.
4. Učenje malog modela: Matcha-TTS (TTS zasnovan na flow matchingu) trenirao sam 5 sati na RTX-u 4090. To je oko 30 tisuća koraka. Za dio koji zvuk vraća u valni oblik, odnosno vokoder, izravno sam upotrijebio javno dostupni Vocos.
Hrvatski se uglavnom čita kako je napisan, pa tekst nisam pretvarao u fonetske oznake nego sam kao ulaz koristio izravno slova. Ipak, lj, nj i dž jedan su glas, pa sam ih tretirao kao jedno slovo.
Usporedba zvuka tijekom učenja
Rečenicu koja nije u podacima za učenje, „Molim Vas, možete li mi reći koliko košta ova haljina?”, sintetizirao sam modelima usred učenja.
korak 5.000 (oko 50 minuta od početka učenja)
korak 10.000 (oko 1 sat i 40 minuta)
korak 15.000 (oko 2 sata i 20 minuta)
korak 20.000 (oko 3 sata i 10 minuta)
korak 30.000 (oko 5 sati, završno)
Za usporedbu, evo jednog primjera podataka za učenje koje je stvorio HiggsAudio u ulozi učitelja (druga rečenica: „Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.”).
Kada se prepiše Whisperom, ova je rečenica od koraka 5.000 do kraja u potpunosti, znak po znak, jednaka scenariju. Drugim riječima, model je od početka znao „što govori”.
Razlika je u čistoći zvuka. Po dojmu pri slušanju, na koraku 5.000 čuje se zrnati šum, koji se do koraka 10.000 znatno smanjio. To se jasno vidi i kada se isti zvuk prikaže spektrogramom (vrijeme vodoravno, frekvencija okomito).
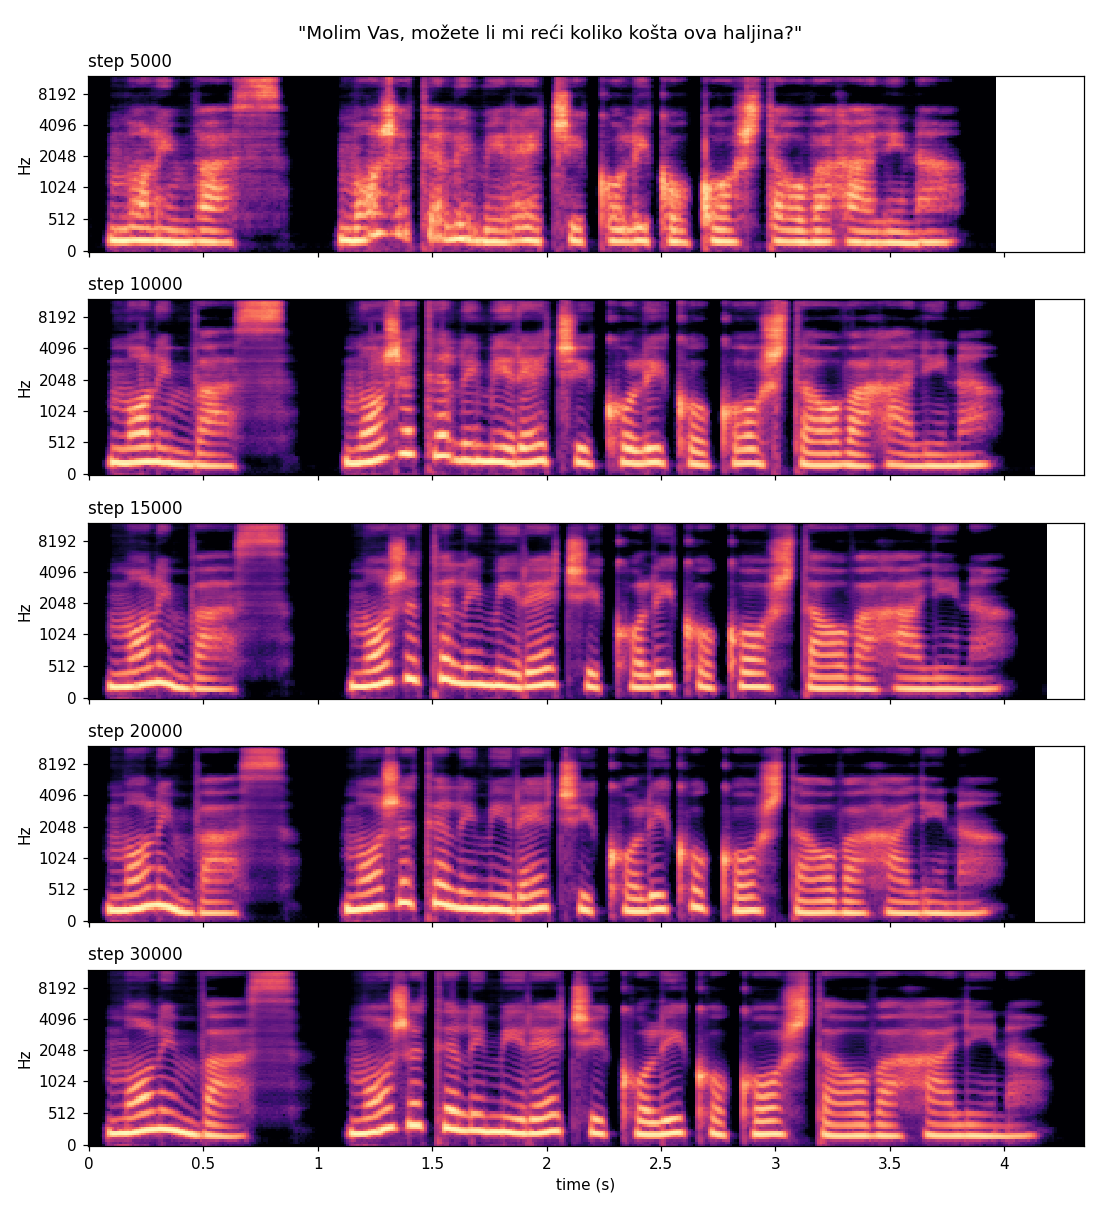
Vodoravne pruge usklađene s visinom glasa (harmonici) na koraku 5.000 razlivene su, a prostori između pruga mutno su popunjeni. To je dio koji se čuje kao šum. Od koraka 10.000 nadalje pruge su jasnije, a međuprostori tamniji. Kako učenje napreduje, pruge se glatko savijaju gore-dolje, pa se čini da je jasnije i kretanje visine glasa, odnosno intonacija.
Pogled u brojke
Četrnaest evaluacijskih rečenica (sve izvan podataka za učenje) prepisao sam Whisperom large-v3 i izmjerio stopu pogrešaka znakova (CER). Uključene su rečenice od kratkih pozdrava do monologa dugih oko 16 sekundi.
| Koraci | Vrijeme učenja | Stopa pogrešaka znakova | Potpuno podudaranje |
|---|---|---|---|
| 5.000 | oko 50 minuta | 1,1 % | 9 / 14 |
| 10.000 | oko 1 sat i 40 minuta | 3,4 % | 8 / 14 |
| 15.000 | oko 2 sata i 20 minuta | 0,7 % | 11 / 14 |
| 20.000 | oko 3 sata i 10 minuta | 0,9 % | 11 / 14 |
| 30.000 | oko 5 sati | 0,9 % | 10 / 14 |
- Lošiji rezultat na koraku 10.000 uglavnom je posljedica toga što je jedna rečenica, „Bok! (bok)”, prepoznata kao „Vok”. Budući da se razlikuje 1 od 3 slova, samo ta rečenica ima stopu pogreške od 33 %. Pri slušanju je korak 10.000 bio mnogo čišći od koraka 5.000. Stopa pogrešaka znakova mjeri samo „je li pročitano”, pa se čistoća zvuka može procijeniti samo slušanjem
- Pogreške koje su ostale do kraja bile su đ i dž u rečenici „Đak je pojeo džem (učenik je pojeo marmeladu)”. To su glasovi koji se i u hrvatskom pojavljuju rijetko, a prepoznati su kao „Žak” i „Džak”
Brzina na CPU-u
Mjerio sam na i7-13700K, u neoptimiziranom PyTorchu. Rezultat je prosjek triju generiranja četiriju rečenica, ukupno 47,6 sekundi zvuka. RTF je „vrijeme potrebno za izradu ÷ trajanje zvuka”; manje je brže.
| Broj dretvi | Broj koraka | Matcha | Vocos | Ukupni RTF |
|---|---|---|---|---|
| 1 | 2 | 0,042 | 0,025 | 0,067 |
| 1 | 4 | 0,067 | 0,025 | 0,092 |
| 4 | 4 | 0,032 | 0,010 | 0,042 |
| 8 | 4 | 0,028 | 0,007 | 0,036 |
„Broj koraka” broj je ponavljanja kojima se tijekom sinteze od šuma stvara zvuk; gornja usporedba snimljena je s 4 koraka. Čak i s jednom dretvom može stvoriti sekundu zvuka za 0,09 sekundi. CPU pametnog telefona bit će sporiji, ali bi i dalje trebao stati u stvarno vrijeme (još nisam mjerio na stvarnom uređaju, pa je to procjena).
Koliko sati podataka treba za TTS?
Budući da se sa 7,5 sati moglo doći dovde, potražio sam opće smjernice.
- LJSpeech, engleski skup koji se često koristi za TTS jednog glasa, ima oko 24 sata. Na njemu je treniran i službeni model Matcha-TTS-a
- Japanski JSUT i kineski CSMSC imaju oko 10 sati te se redovito koriste kao korpusi jednog glasa
- Za učenje od nule, oko 1 sat je donja granica; ovisno o modelu, pogreške u izgovoru mogu se povećati
- Za dodatno učenje već istreniranog modela postoji izvješće da je 30 minuta dalo otprilike rezultat kao 27 sati učenja od nule
Postoji i istraživanje o učenju Matcha-TTS-a isključivo na sintetiziranom govoru (Sveučilište Jiao Tong u Šangaju, prosinac 2025.). Navodi da rezultat poboljšava veća raznolikost tekstova, čist zvuk bez šuma i ujednačen stil govora. Budući da sintetizirani podaci nemaju šuma i imaju ujednačen stil govora, za isto trajanje možda ih je lakše učiti nego stvarne snimke. To se čini u skladu s time što je ovdje 7,5 sati bilo dovoljno za ovakav rezultat.
Na što sam naišao
- Računalo se zamrznulo: model od 31B za izradu scenarija slučajno se dvaput istodobno učitao na GPU i prepunio VRAM. Od tada vrijedi pravilo: „na GPU-u je uvijek samo jedan model”
- Gemma 4 previše razmišlja: oko dvije trećine izlaza bilo je „razmišljanje”. Nakon što sam ga isključio, rad je postao oko triput brži
- Halucinacije HiggsAudija: u prvom testu, nakon tišine na kraju rečenice, samovoljno je nastavio s „Hvala što pratite kanal” i nastao je isječak od 81 sekunde. Izgleda kao da pamti završne rečenice s YouTubea. Počeo sam odbacivati snimke čije trajanje znatno odstupa od očekivanog
- Matcha-TTS ne radi na Windowsu: neke C ekstenzije nije bilo moguće izgraditi, pa sam taj dio prepisao u Pythonu (numba)